在具身智能领域蛰伏三周的“神秘模型”终于揭开面纱。此前,一款代号为motubrain的模型悄然登顶两大国际权威评测基准——worldarena(聚焦物理世界理解能力)与robotwin2.0(聚焦动作执行精度),引发业界高度关注与诸多猜想。近日,凭借视频生成大模型vidu广受瞩目的生数科技正式官宣:该模型正是其面向具身智能场景打造的首个可商用落地的核心引擎。
此次突破绝非概念性尝试。MotuBrain在上述两项评测中均刷新历史最高分纪录。尤为突出的是,在引入高频随机扰动的强干扰测试环境中,它是目前唯一实现平均得分突破95分的模型,充分验证了其在复杂动态场景下的卓越鲁棒性与泛化性能。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
“所见即所动”:重构感知与行动的耦合逻辑
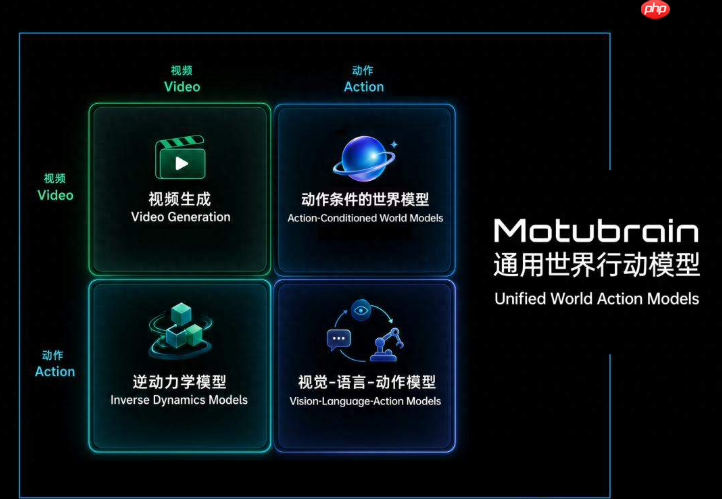
区别于传统“先规划、再执行”的串行范式,MotuBrain开创性地采用“世界动作模型”(World Action Model)架构。这一“边感知、边推演、边执行”的实时闭环机制,使决策与动作同步演化,有效抑制误差累积,显著缩短端到端响应延迟。
在真实场景演示中,搭载该模型的机器人展现出类人级的任务理解力。例如在火锅用餐模拟任务中,机器人能依据实时视觉反馈判断勺中是否有食材,并据此动态调整后续动作——若为空则主动补捞,而非机械复刻固定流程。这种基于情境自主判断的行为逻辑,标志着具身系统正从指令驱动迈向认知驱动。
一脑适配多形态,长程任务无缝贯通
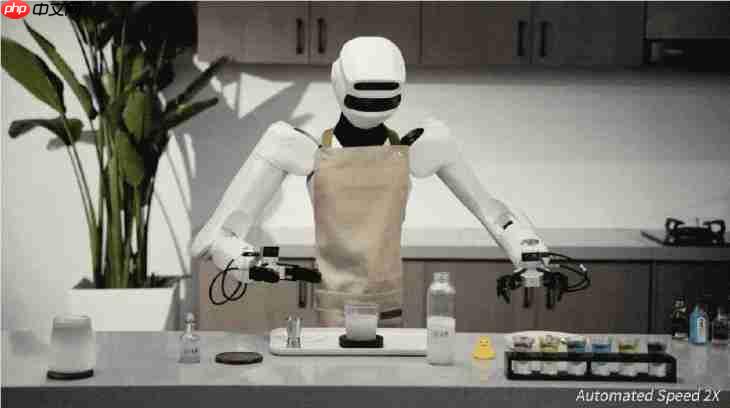
MotuBrain的核心竞争力在于其高度统一的通用表征能力。它不仅支持“一脑多型”,可灵活适配不同构型、自由度及传感配置的机器人硬件平台;更具备“一脑贯全程”的长时序任务统筹能力。在插花、调酒、家居整理等多类复杂任务中,系统可连续稳定完成逾10个细粒度原子动作,全流程自然连贯,全程无需人工介入或重置。
实测数据显示,随着任务类型多样性提升,MotuBrain的学习成功率呈现正向增长趋势。这表明模型习得的是物理交互中的普适性规律,而非针对特定动作的过拟合模板——任务越丰富,其底层建模能力越扎实,表现也越稳健。
扎根物理世界,构建数字与实体协同演进新范式
生数科技此次成果的背后,是其长期深耕多模态基础架构的技术沉淀。依托全球首创的U-ViT统一架构,公司首次实现了虚拟生成模型(VGM)与具身动作模型(WAM)的同源协同。左手以
Vidu高效构建高保真数字世界,右手借
MotuBrain精准操控真实物理实体,双轨并进大幅降低真实数据采集成本,加速模型迭代闭环。
现阶段,生数科技已与无界动力、星尘智能等多家具身智能头部企业签署战略合作协议。随着行业竞争焦点由单点能力转向通用智能体构建,掌握真正可迁移、可扩展、可部署“具身大脑”的技术方,正逐步成为定义下一代智能终端生态的关键主导者。