





OpenResty的lua_shared_dict存在锁竞争与过期数据回收两大隐性瓶颈:高频单key写引发slab锁争用抬高P99延迟,惰性清理导致内存碎片和假性满载;需拆分key、异步写、启用get_stale、定期flush、监控capacity/items比、C层只读不写并校验zone。
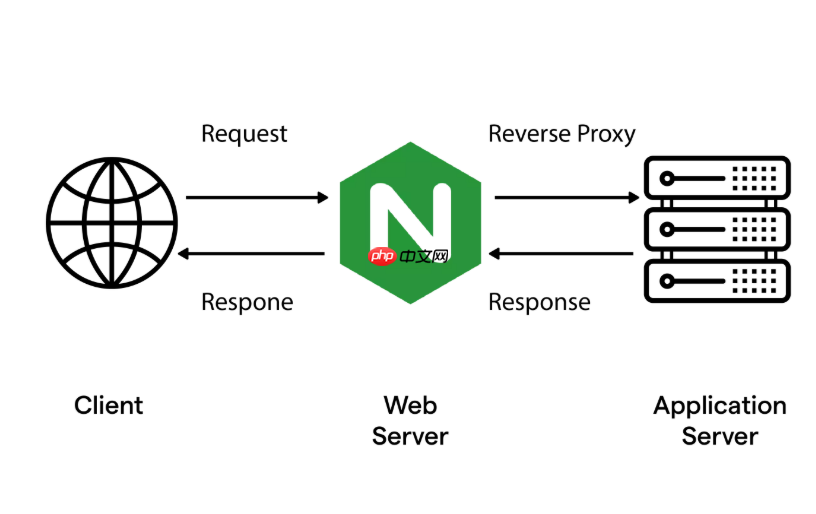
OpenResty 的 lua_shared_dict 是高性能缓存的核心,但它不是“开箱即用就无瓶颈”的黑盒。在万级 QPS 场景下,常见两个隐性问题:一是多协程争抢同一 key 的 set/get 触发 slab 锁竞争,导致延迟毛刺;二是过期数据不及时回收,长期运行后有效内存利用率下降、甚至触发 OOM。这些问题不会在压测初期暴露,却会在业务峰值时突然恶化。
锁竞争的本质与规避策略
shared dict 底层基于 Nginx slab 分配器,所有读写操作都需加锁保护哈希桶和内存块。当大量请求高频更新同一个 key(比如全局计数器、热点配置),或使用短 TTL 频繁淘汰+重建同一 key 时,锁争用会显著抬高 P99 延迟。
- 避免对单个 key 的密集写:把大状态拆成多个 key,例如将
user:123:profile拆为user:123:profile:basic、user:123:profile:ext,分散锁粒度 - 写操作尽量异步化:用
ngx.timer.at延后非关键写入,或改用 Redis + Lua 原子指令处理计数类逻辑,不压 shared dict - 读多写少场景启用
get_stale:允许读取已过期但尚未被清理的数据,跳过锁等待,再由后台协程异步刷新,适合降级兜底
内存碎片与 stale 数据回收机制
shared dict 不主动扫描清理过期项,只在 get/set 时惰性剔除。若某些 key 写入后极少被访问,其内存将长期滞留,造成“假性满载”——dict:info() 显示 used_memory 接近上限,但实际活跃 key 不多。
- 定期触发主动清理:在
init_worker_by_lua*中启动定时器,调用dict:flush_all()或按前缀批量delete,注意避开业务高峰 - 监控真实水位:不要只看
max_size,重点关注capacity(可用槽位数)和items(当前条目数),items / capacity > 0.75就该预警 - 设置合理 TTL:避免全设为 0(永不过期),尤其对动态数据;对静态配置可设长 TTL(如 3600s),配合版本号(如
config:v2)实现原子切换,而非覆盖更新
Lua 层与 C 模块协同访问的边界控制
当 C 模块需要读 shared dict 时,必须严格遵循生命周期约束,否则极易引发段错误或读到脏数据。
- C 模块只能读,不能写:OpenResty 官方不保证 C 层 write 的线程安全,所有写操作必须收口到 Lua 层统一调度
- 确保 zone 已初始化:C 代码中必须先调用
ngx_http_lua_find_zone获取 valid ctx,不可硬编码指针;且仅限 worker 进程上下文调用 - 类型限制明确:C 层通过
ngx_http_lua_shdict_get_str_value只能取 string/number,binary 数据需 base64 编码后再存,避免截断
验证与可观测性建议
优化不是调完参数就结束,要建立闭环验证能力。
- 用
dict:get_keys(0)抽样检查 key 分布,确认无异常聚集(如 80% key 都带相同前缀) - 开启
ngx.log(ngx.DEBUG, ...)记录 cache miss/hit ratio 和 set latency,在日志中埋点统计 - 通过
resty.core.shdict的info方法暴露 Prometheus 指标,监控shared_dict_used_ratio和shared_dict_lock_wait_ms




















