


Nginx事件循环不直接处理后端连接重置,该容错由upstream模块基于epoll/kqueue就绪通知、socket错误码识别及重试机制协同实现;重置在read/write/connect阶段通过recv/send/connect返回值及errno判定,由具体handler如ngx_http_upstream_process_header触发ngx_http_upstream_next()进入重试流程;重试行为受proxy_next_upstream等指令控制,并依赖自动socket关闭与upstream context清理保障资源安全。
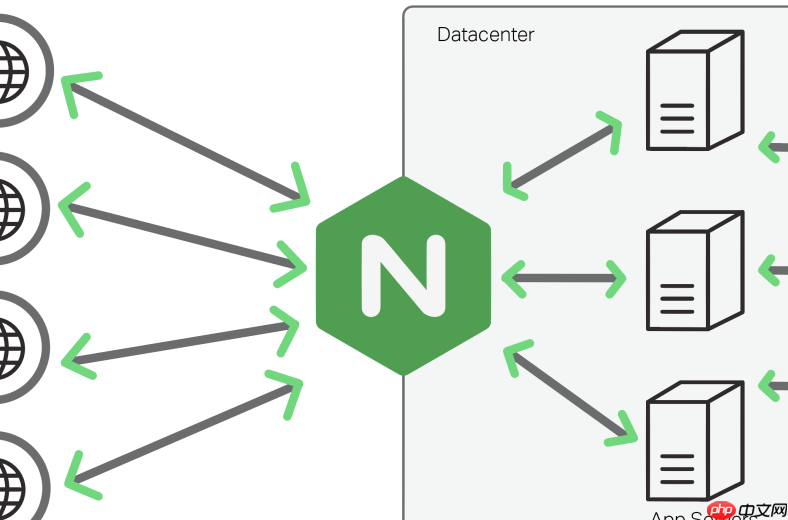
Nginx 的事件循环(Event Loop)本身不直接处理“后端连接重置”的容错逻辑,这类错误的检测与恢复由 upstream 模块在事件驱动框架之上实现,核心依赖于 epoll/kqueue 的就绪通知、socket 错误码识别,以及 upstream 重试机制的协同。
连接重置的典型触发时机
后端(如 FastCGI、proxy_pass 目标、gRPC server)异常关闭连接时,Nginx 在读/写阶段可能收到以下信号:
- read 阶段:recv() 返回 0(对端正常关闭)或 -1 且 errno == ECONNRESET / EPIPE
- write 阶段:send() 或 writev() 失败,errno 为 ECONNRESET、EPIPE 或 EAGAIN/EWOULDBLOCK(但后者非重置)
- connect 阶段:connect() 返回 -1 且 errno == ECONNREFUSED,或超时后被 epoll 判定为失败
EventLoop 如何感知并传递错误
Nginx 的 event loop(如 ngx_epoll_process_events)只负责分发 I/O 就绪事件。真正判断“连接重置”的是上游模块中具体的 handler,例如:

- ngx_http_upstream_process_header() 在读响应头时发现 recv() == 0 或 errno == ECONNRESET → 触发 ngx_http_upstream_next()
- ngx_http_upstream_send_request() 写请求体失败 → 调用 ngx_http_upstream_fail() 标记当前 peer 不可用
- 所有失败路径最终会调用 ngx_http_upstream_next(),进入重试决策流程
upstream 重试与容错的关键控制点
是否重试、重试几次、换哪个 backend,由 upstream 指令和当前状态共同决定:
- proxy_next_upstream error timeout http_500;:明确将 connection reset 归类为 error,触发重试(默认已包含)
- proxy_next_upstream_tries 3;:最多尝试 3 个不同的 upstream server(含首次)
- proxy_next_upstream_timeout 5s;:总重试耗时上限,超时则返回错误
- 若使用 ip_hash / hash $request_uri consistent; 等负载策略,重试时可能仍打到同一台 server —— 此时需配合 max_fails=1 fail_timeout=10s 实现被动健康检查
避免雪崩:连接重置后的资源清理
一次重置不处理干净,可能引发 fd 泄露或内存堆积:
- Nginx 自动关闭出问题的 socket 并释放 ngx_event_t、ngx_connection_t 结构
- 但 upstream request context(如 ngx_http_upstream_s)需在 ngx_http_upstream_finalize_request() 中完整清理,尤其注意 subrequest、buffer chain 和临时文件
- 若启用了 proxy_buffering off;,响应流式转发中重置会导致部分 buffer 未消费 → Nginx 会主动丢弃剩余 input chain,不阻塞 event loop











