


当所有后端服务实例性能一致时,Nginx默认轮询算法最简单高效;其按配置顺序循环分发请求,不感知响应时间,需配合健康检查与weight=1等配置保障公平性。
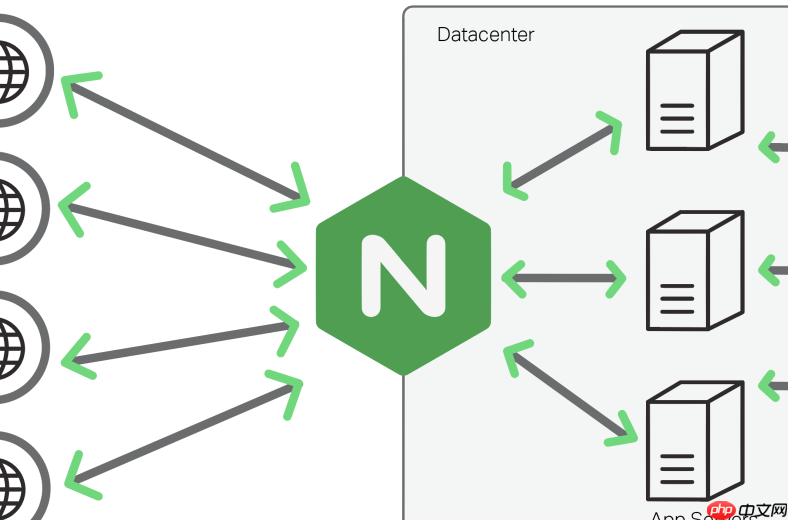
当所有后端服务实例性能一致、无明显差异时,Nginx 默认的轮询(Round Robin)算法是最简单高效的选择。它不依赖额外状态或复杂计算,按请求顺序逐一分发,天然契合“对等”这一前提。
轮询的核心行为与默认特性
Nginx 的 upstream 模块在未显式指定负载均衡策略时,自动启用加权轮询(Weighted Round Robin),但所有 server 权重默认为 1,等效于标准轮询。每个请求严格按配置中 server 的声明顺序依次分配,循环往复。
- 连接建立前即完成节点选择,不感知后端响应时间或当前连接数
- 不自动剔除宕机节点——需配合 max_fails 和 fail_timeout 实现被动健康检查
- 重启 Nginx 后调度序列重置,无会话保持或历史状态延续
确保真正“对等”的关键配置项
即使后端硬件相同,网络延迟、系统负载或临时 GC 也可能打破对等性。通过以下配置可增强轮询的公平性与鲁棒性:

-
显式设置 weight=1:避免隐式继承或配置污染,例如
server 10.0.1.10:8080 weight=1; -
启用健康检查:添加
max_fails=3 fail_timeout=30s,使异常节点短暂退出轮询队列 -
限制单节点连接数:使用
max_conns(需 Nginx Plus 或 1.11.5+ 开源版),防止单节点过载影响整体轮询节奏
常见误用与排查建议
看似简单的轮询,实际运行中易因环境因素出现“看似不均”的现象:
-
长连接场景下流量倾斜:HTTP/1.1 持久连接导致部分 worker 进程长期绑定某后端,可通过
keepalive指令控制连接池大小,并搭配keepalive_requests限频缓解 -
日志显示不均 ≠ 实际分发不均:检查 access_log 中 $upstream_addr 字段是否真有偏差;更可靠的方式是用
stub_status或 Prometheus + nginx-module-vts 统计各 upstream 的请求计数 -
DNS 缓存干扰:若 upstream 使用域名,Nginx 默认只解析一次。应改用 IP,或启用
resolver+valid实现动态 DNS 更新
何时该放弃轮询?
轮询不是万能解。一旦出现以下情况,就说明“对等”假设已被打破,需切换策略:
- 后端响应时间差异持续超过 200ms,且影响用户体验 → 考虑 least_conn 或 ip_hash(如需会话粘性)
- 部分实例部署了新版本,需灰度引流 → 改用 weight 手动调节比例
- 需根据请求头或参数定向分发(如 /admin → 特定集群)→ 切换至 split_clients 或 map + upstream 动态路由















