





Nginx Worker负载不均主因是外部因素或配置不当;应启用accept_mutex减少惊群、使用reuseport由内核均衡分发连接、合理设置worker_processes与worker_connections,并结合监控定位真实瓶颈。
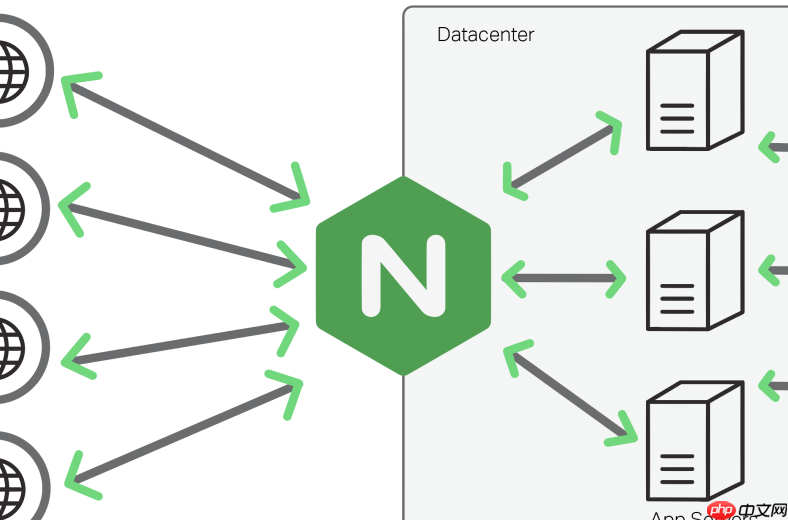
在Nginx多进程模型中,Worker进程负载不均通常不是因为Nginx本身调度失效,而是由外部因素或配置不当引发。核心思路是:让内核的accept()系统调用分发更均衡、减少惊群效应、避免长连接或慢请求持续占用单个Worker。
启用accept_mutex降低惊群效应
Nginx默认开启accept_mutex on(1.11.3+版本默认on),它让Worker进程通过互斥锁竞争accept队列中的新连接,避免多个Worker同时被唤醒(即“惊群”)。若关闭该选项,所有Worker都可能争抢同一连接,导致部分进程空转、部分过载。
- 确认配置中未显式设置accept_mutex off
- 高并发短连接场景下,保持默认开启即可;若使用reuseport(见下条),可考虑关闭,因内核已做分发
启用SO_REUSEPORT(Linux 3.9+)由内核分发连接
在支持SO_REUSEPORT的系统上,Nginx可通过listen ... reuseport指令,让内核在多个Worker绑定同一端口时,直接按哈希将新连接分发到不同Worker的socket队列,天然规避惊群且更均衡。
- 需Linux内核≥3.9,且Nginx≥1.9.1编译时启用了reuseport支持
- 配置示例:listen 80 reuseport;(每个worker_processes对应一个独立监听套接字)
- 注意:与accept_mutex互斥,启用reuseport后建议关闭accept_mutex
合理设置worker_processes和连接分配策略
worker_processes设为auto或CPU核心数只是起点。若存在大量长连接(如WebSocket、HTTP/2)、慢客户端或后端阻塞,单个Worker可能积压大量请求,而其他Worker空闲。
- 检查worker_connections是否过小,导致连接排队集中在少数Worker
- 启用multi_accept on,让每个Worker一次尽可能多地accept连接,减少轮转延迟
- 对长连接服务,考虑配合keepalive_timeout和keepalive_requests限制单连接生命周期和请求数
监控与定位真实瓶颈
负载不均常是表象,背后可能是上游代理不均、后端响应差异大、或某Worker因日志刷盘/SSL握手卡住。不能只调参数,要结合指标验证:
- 用nginx -s status(需第三方模块)或stub_status查看各Worker活跃连接数(需配合进程ID区分)
- 用ps -eo pid,comm,%cpu,%mem,rss --sort=-%cpu | head -20观察各Worker CPU/内存占用是否显著偏离
- 检查access.log中$upstream_addr字段,确认上游分发是否均匀;用$pid变量记录日志,分析各Worker处理请求分布

















