




Nginx需主动探测并清理失效keepalive连接以避免502等错误:配置keepalive参数(如keepalive 32、keepalive_timeout 60s)、启用proxy_socket_keepalive on及proxy_next_upstream容错重试,并通过日志与监控验证效果。
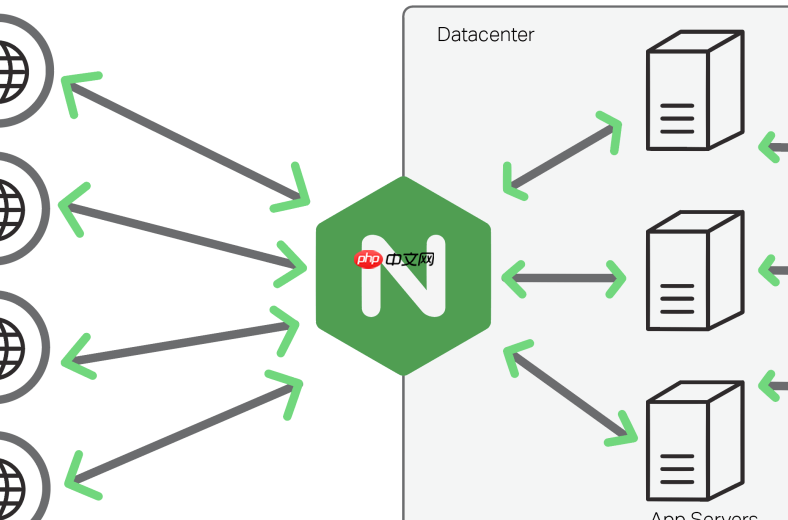
Nginx 使用异步事件驱动模型(如 epoll/kqueue)高效处理大量并发连接,但当它与后端服务(如上游 HTTP 服务)建立 keepalive 连接后,若后端主动关闭空闲连接(如超时断开),Nginx 默认不会立即感知该断连,导致后续请求复用已失效的连接而失败(如 502 Bad Gateway 或 upstream prematurely closed connection)。解决核心在于让 Nginx 主动探测、及时清理并重建失效的 keepalive 连接。
启用 upstream keepalive 并配置健康探测
确保 upstream 块中正确启用了连接池,并设置合理的 keepalive 参数:
-
keepalive N:定义每个 worker 进程为该 upstream 保留的最大空闲长连接数(如
keepalive 32); - keepalive_requests:单个 keepalive 连接最多承载的请求数(默认 100,建议设为 1000+ 避免过早释放);
-
keepalive_timeout:空闲连接在 Nginx 端保留的最长时间(单位秒,如
keepalive_timeout 60s),需略小于后端实际 keepalive 超时(例如后端设 75s,则 Nginx 设 60s); - 配合 health_check(需商业版或 OpenResty)或 proxy_next_upstream 实现被动健康检查。
利用 proxy_next_upstream 主动容错重试
即使连接已失效,Nginx 可在首次失败后自动切换到其他可用后端或重连:
- 在 location 或 upstream 中配置:
proxy_next_upstream error timeout http_502 http_503 http_504; - 搭配
proxy_next_upstream_tries 3和proxy_next_upstream_timeout 5s控制重试次数与总耗时; - 注意:该机制不预防失效连接复用,而是兜底恢复——需与 keepalive_timeout 配合才能减少触发频率。
通过 proxy_socket_keepalive 强化 TCP 层保活
从 TCP 层辅助检测连接是否真实存活(尤其适用于后端无应用层心跳场景):
- 添加
proxy_socket_keepalive on;(Nginx 1.15.6+ 支持); - 可进一步细化:
proxy_socket_keepalive on:60:3:10;表示开启保活、空闲 60 秒后发探测包、最多重试 3 次、每次间隔 10 秒; - 该设置让内核在连接空闲时主动发送 TCP keepalive 探测,一旦发现对端已关连接,会立即向 Nginx 返回 RST,使其快速清理连接池中的失效句柄。
监控与日志辅助定位失效模式
确认问题是否缓解,需结合日志与指标分析:
- 开启
error_log /var/log/nginx/error.log debug;(临时)观察upstream socket keepalive、connect failed、connection reset by peer等关键信息; - 使用
stub_status或 Prometheus exporter(如 nginx-module-vts)监控Active connections、Upstream keepalive pool size及失败率; - 重点关注
upstream prematurely closed connection while reading response header from upstream是否明显下降。
















