


slow_start是Nginx 1.19.5+及Plus支持的upstream参数,用于新/恢复节点在指定时间内线性提升权重,解决冷启动时因缓存未热、连接池空、JVM未预热导致的响应慢或失败问题。
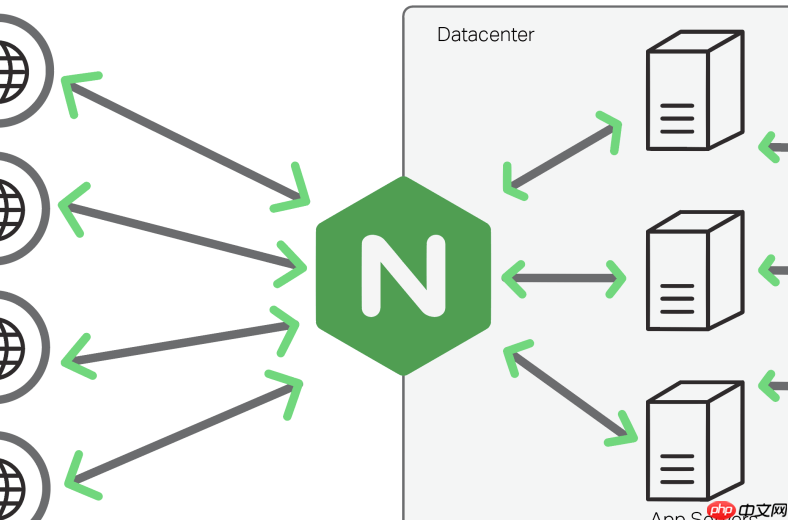
当后端服务刚上线或重启时,直接全量接收流量容易因初始化未完成(如缓存未热、连接池为空、JVM未预热)而响应变慢甚至失败。Nginx upstream 的 slow_start 参数正是为此设计:它让新加入的服务器节点在指定时间内逐步提升权重,实现平滑“冷启动”。
slow_start 是什么?它解决什么问题?
slow_start 是 Nginx Plus(商业版)和开源版 Nginx 1.19.5+ 支持的 upstream 指令参数,用于控制新添加或恢复的服务器节点如何“渐进式”承担流量。
典型场景包括:
- 滚动发布时,新 Pod 启动后立即被加入 upstream,但业务尚未就绪;
- 某台后端宕机恢复后,Nginx 健康检查通过,但数据库连接、本地缓存等仍需时间重建;
- Java 应用刚启动,JIT 编译未生效,首请求延迟高,批量涌入会放大雪崩风险。
没有 slow_start,Nginx 默认立即按 full weight 分发请求;启用后,该节点权重从 0 开始,在设定时间内线性增长至配置值。
如何配置 slow_start?关键细节说明
语法如下(必须配合 weight 使用):
server 10.0.1.10:8080 weight=10 slow_start=30s;
含义:该节点初始权重为 0,30 秒后权重升至 10,并保持稳定。
注意事项:
-
仅对“新加入”或“刚恢复”的节点生效:已在线节点重启
nginx -s reload不触发 slow_start;只有健康检查失败后又恢复,或首次加入 upstream 时才启动计时; -
依赖健康检查:必须开启
health_check或使用max_fails/fail_timeout配合,否则 Nginx 无法感知“恢复”事件; -
不适用于轮询外的负载均衡算法:仅在
round_robin(默认)或least_conn下有效;ip_hash、hash 等静态策略不支持; -
最小 slow_start 时间为 1 秒,单位支持 s(秒)、ms(毫秒),例如
slow_start=500ms。
搭配 health_check 实现真正可靠的冷启动
单独写 slow_start 不够——若健康检查太宽松,节点可能“假恢复”就被加回流量。推荐组合配置:
upstream backend {
    zone backend 64k;
    # 更激进的健康检查:2s探测一次,连续2次失败即摘除,10s后尝试恢复
    server 10.0.1.10:8080 weight=10 slow_start=45s max_fails=2 fail_timeout=10s;
    server 10.0.1.11:8080 weight=10 slow_start=45s max_fails=2 fail_timeout=10s;
}
<h1>同时启用主动健康检查(需 Nginx Plus 或开源版 1.13.3+)</h1><p>match backend_ok {
status 200;
body ~ "OK";
}
health_check interval=3 fails=2 passes=2 match=backend_ok;
这样能确保:
– 节点真正就绪(返回健康检查 OK)才开始 slow_start 计时;
– 即使短暂超时或 GC,也不会被误判为“永久故障”;
– 流量在 45 秒内从 0% 平滑过渡到 100%(相对权重)。
常见误区与替代思路
误区示例:
- 认为 reload nginx 就能重置 slow_start:实际不会,reload 后节点状态继承,slow_start 不重启;
- 给所有节点统一配 slow_start=60s:长期运行节点无需此参数,反而降低可用容量;应只加在易波动或新部署节点上;
- 忽略上游服务自身就绪探针:K8s readiness probe 应与 Nginx 健康检查语义一致,避免“容器就绪但 Nginx 还没加它”或“Nginx 加了但应用还没 ready”。
若无法升级 Nginx 版本(低于 1.19.5),可临时用以下方式模拟:
- 发布前先以
weight=0加入节点,等日志确认就绪后,再nginx -s reload更新为正常 weight; - 结合外部脚本 + API(如 Nginx Plus REST API 或 OpenResty lua-resty-upstream-healthcheck)动态调整 weight。










