


limit_req依托epoll事件驱动与共享内存实现高效限流:请求在PREACCESS阶段内存中查写状态,零系统调用;合理配置key、zone大小、burst及nodelay可优化性能;避免复杂key与冗余zone以防止开销上升。
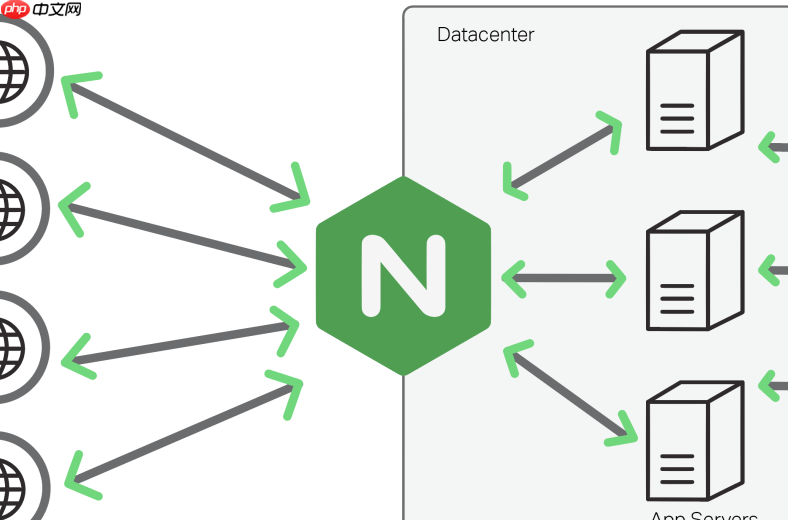
Nginx 通过 epoll 事件驱动模型高效处理大量并发连接,而 limit_req 模块正是依托这一机制,在不显著增加 CPU 开销的前提下,实现精准、低延迟的请求速率限制。
limit_req 的底层依赖:epoll 与共享内存
limit_req 并非靠定时轮询或线程阻塞实现限流,而是利用 Nginx 的事件驱动架构:
- Nginx 主循环基于
epoll_wait()监听 socket 事件,所有请求到达都以事件形式被快速捕获; - 限流状态(如每个 key 的最近请求时间、当前计数)存放在
shared memory zone中,所有 worker 进程可无锁读写(通过原子操作和 slab 分配优化); - 每次请求在
NGX_HTTP_PREACCESS_PHASE阶段即时查表+更新状态,全程在内存中完成,无系统调用或磁盘 I/O。
核心配置项如何影响 epoll 下的性能表现
合理配置能进一步释放 epoll + 共享内存的效率优势:
-
limit_req_zone $binary_remote_addr zone=ip_limit:10m rate=10r/s:使用$binary_remote_addr减少字符串哈希开销;10m区域大小需预估 key 数量(约每 64 字节存一个 key),避免频繁淘汰; -
limit_req zone=ip_limit burst=20 nodelay:启用burst提供平滑缓冲;若去nodelay,则排队等待会引入微小延迟,但更公平;加nodelay则突发请求立即响应或拒绝,适合对延迟敏感场景; - 配合
multi_accept on和accept_mutex off(高并发时),让单次epoll_wait触发后尽可能多地 accept 连接,减少事件循环次数。
避免常见性能陷阱
即使有 epoll,错误用法仍会导致限流变重或失效:
- 勿用复杂变量做 key(如
$request_uri或带参数的 URL),哈希与比较成本高,且易触发共享内存满;优先选固定长度字段如$binary_remote_addr或$server_name; - 不要为每个 location 单独建大 zone,应复用 zone,按需调整
burst和rate参数; - 日志中开启
$limit变量(需编译时含--with-http_realip_module等支持),便于验证是否真正在限流路径上执行,而非因配置未生效绕过。
限流本身不是瓶颈,关键在于让 Nginx 在 epoll 事件流中以最轻量方式完成判断——共享内存查写、原子操作、零拷贝 key 处理,这才是 limit_req 在万级 QPS 下依然稳定的原因。












