


网关系统通过模块化设计优化系统调用:聚合批处理(如 writev)、零拷贝链路(AF_XDP/io_uring)、异步事件驱动(io_uring DNS/连接池)、inotify热更新、eBPF内核旁路(sk_skb/sockops),显著降低上下文切换与拷贝开销。
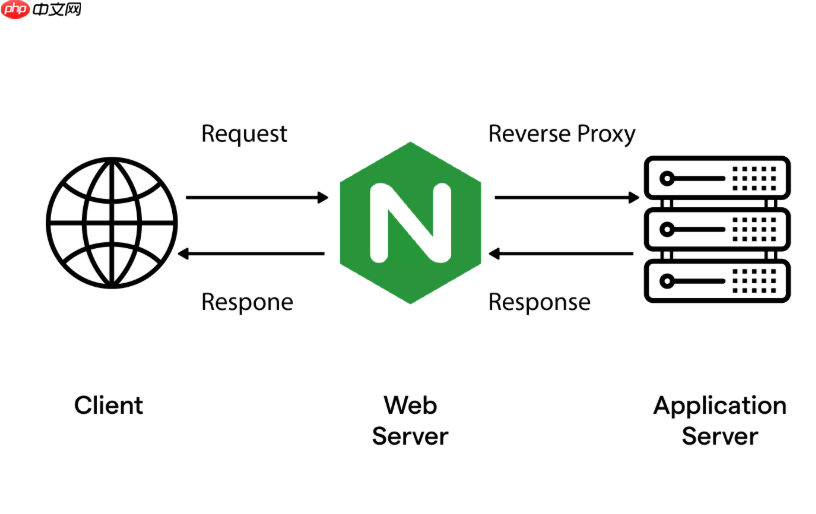
在网关系统中,频繁的系统调用(如 read、write、sendfile、epoll_wait 等)是性能瓶颈之一,尤其在高并发小包场景下,上下文切换和内核态/用户态拷贝开销显著。模块化开发本身不直接减少系统调用,但通过合理设计模块职责、数据流与内存管理,可大幅压缩无效或重复调用,从而提升吞吐量。
模块内聚:将多次系统调用合并为单次批处理
避免每个请求都单独触发 writev 或 send。可在协议解析模块或响应组装模块中引入缓冲聚合逻辑:
- HTTP 响应模块不立即发送,而是写入线程本地环形缓冲区,由独立 I/O 调度模块按时间窗口(如 100μs)或缓冲水位(如 ≥4KB)批量调用
writev - 上游代理模块对多个后端响应做零拷贝拼接(如使用
splice+memfd_create),再统一投递,避免多次read+write组合 - 日志模块禁用每请求
write,改用异步 ringbuffer + 单线程 flush,系统调用频次从 QPS 级降至毫秒级
零拷贝模块:绕过用户态内存搬运
传统模块间传递数据常依赖 memcpy,触发隐式页表更新与 cache 污染,间接增加后续系统调用开销。可通过以下方式构建零拷贝链路:
- 接入层模块(如 TCP acceptor)直接将 socket buffer 引用(
struct iovec或struct msghdr)移交解析模块,避免recv拷贝到用户缓冲区 - 使用
AF_XDP或io_uring的 SQE 提交机制,让网络模块与业务模块共享同一内存池(如 DPDK mbuf 或用户态 page pool),数据始终在内核预留页中流转 - JWT 校验、限流等中间件模块改为就地解析(如用
libbpf在 eBPF map 中预存规则),不读取完整 payload,省去read和内存分配
事件驱动模块:消除阻塞式系统调用
传统同步模块(如 DNS 解析、Redis 调用)易因 connect、recv 阻塞线程,导致 epoll 循环停滞,引发连锁延迟。应将此类功能拆分为非阻塞子模块:
- DNS 模块封装为异步 resolver,基于
io_uring的IORING_OP_ASYNC_RECV或getaddrinfo_a,回调通知而非轮询 - 下游通信模块统一抽象为“连接池+状态机”,所有 socket 操作(
connect、send、recv)均注册到 event loop,由主 I/O 模块集中 dispatch,避免模块各自epoll_ctl - 配置热更新模块使用 inotify +
read单次监听,而非定时stat,将调用从周期性降为事件触发
内核旁路模块:用 eBPF 替代用户态系统调用
对高频、低延迟路径(如 ACL 过滤、TLS 版本协商、Header 重写),可将逻辑下沉至 eBPF 模块,在内核协议栈收发路径上执行:
- 在
sk_skb程序中解析 IP/TCP 头并匹配黑白名单,命中即bpf_skb_drop,完全跳过用户态网关模块和后续recv - 用
sockops程序自动设置TCP_FASTOPEN、TCP_NODELAY,无需用户态反复setsockopt - HTTP/2 流控模块通过
sk_msg程序在 sendmsg 前修改 frame header,避免用户态解析+序列化+系统调用三重开销
模块不是功能堆砌,而是系统调用的“整合器”与“过滤器”。关键在明确每个模块的系统调用边界——谁发起、谁聚合、谁旁路、谁消解。设计时以“一次调用承载多业务语义”为目标,吞吐量提升自然水到渠成。












