


Nginx重试是事件驱动的被动机制,需同时满足连接建立、未响应、可重试错误、配置允许及有备用节点五个条件;proxy_next_upstream_tries限制尝试节点数,proxy_next_upstream_timeout限制总耗时。
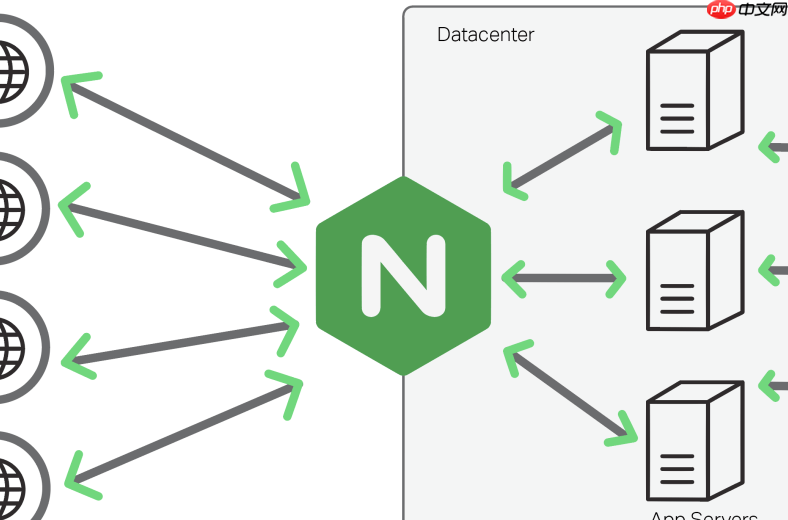
Nginx 在非阻塞模式下本身不“主动”管理后端超时重试的逻辑,而是通过配置指令协同事件驱动模型完成重试行为。关键在于理解:Nginx 的重试不是由某个线程轮询等待,而是靠 epoll/kqueue 事件通知 + 状态机跳转 + 配置阈值触发的被动重试机制。
重试触发的前提条件
只有满足以下全部条件,Nginx 才会发起重试:
- 后端服务器连接已建立(或能快速复用 keepalive 连接),但响应未在 proxy_read_timeout 内返回;
- 请求尚未向客户端发送任何响应体(即未进入流式传输阶段);
- 后端服务返回的是可重试错误码(如 502、503、504)或连接被主动关闭(connection refused / reset by peer);
- 配置了 proxy_next_upstream 并明确包含对应错误类型(例如
error timeout http_502 http_503); - 可用的 upstream server 数量 ≥ 2,且至少还有一个未尝试过的 backup 或非故障节点。
proxy_next_upstream_timeout 与 proxy_next_upstream_tries 的作用
这两个指令控制重试行为的“边界”,而非“循环次数”:
- proxy_next_upstream_tries:限制最多尝试多少个 upstream server(默认为 0,表示不限),每次切换 server 算一次尝试;
- proxy_next_upstream_timeout:限制整个重试过程的总耗时(从首次发起请求开始计时),超时即终止重试并返回最终错误;
- 注意:单次请求到某个 backend 的超时仍由 proxy_connect_timeout、proxy_send_timeout、proxy_read_timeout 分别控制,它们不因重试而累加。
非阻塞下的真实执行流程
以一个典型 timeout 重试为例:
- Nginx 向 backend A 发起异步写请求,注册读事件监听;
- backend A 无响应,epoll 返回超时事件 → Nginx 判定本次请求失败;
- 检查 proxy_next_upstream 是否允许重试 timeout,且当前尝试次数未超 tries、总耗时未超 timeout;
- 若满足,则选择下一个 upstream server(B),复用已有连接或新建连接,再次异步发起请求;
- 整个过程不阻塞 worker 进程,同一 worker 仍可处理其他 client 请求或 backend 响应事件。
常见配置建议
避免无效重试或雪崩,推荐如下最小安全配置:
- proxy_connect_timeout 5s; —— 建立 TCP 连接上限;
- proxy_send_timeout 10s; —— 发送完整请求体的上限;
- proxy_read_timeout 15s; —— 等待响应头/体的上限;
- proxy_next_upstream error timeout http_502 http_503 http_504;
- proxy_next_upstream_tries 3; —— 最多换 3 台机器试;
- proxy_next_upstream_timeout 30s; —— 整个重试流程最长 30 秒。













