





Nginx Worker进程采用独占式事件循环,通过epoll异步处理分配的连接事件;合理绑定CPU核心、启用reuseport、避免阻塞操作可显著提升吞吐率。
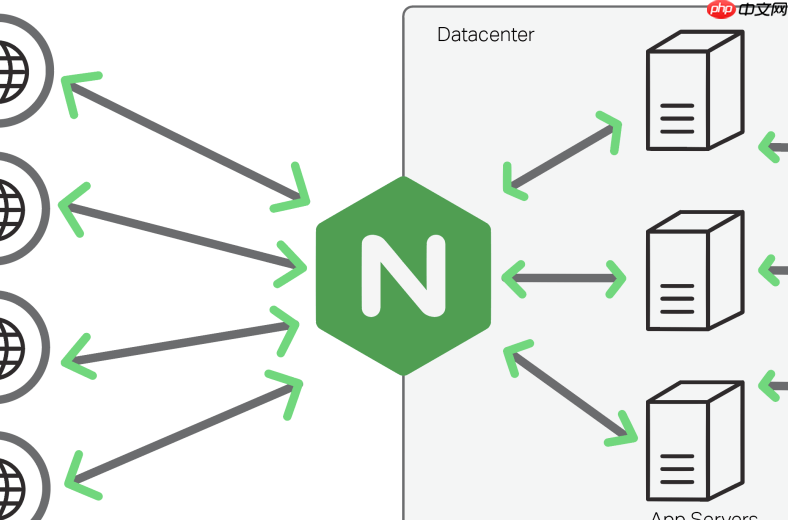
在 Nginx 中,Worker 进程采用“独占式处理网络事件”的设计,并不意味着每个 Worker 独占一个物理 CPU 核心或独占一条 TCP 连接,而是指:每个 Worker 进程独立、非协作地运行在自己的事件循环中,通过 epoll(Linux)等 I/O 多路复用机制,**独占地监听并处理分配给它的所有连接的读写事件**。这种模型对吞吐率的影响是双刃剑——合理配置时可逼近硬件极限,配置不当则易成为瓶颈。
Worker 进程与 CPU 核心的绑定提升吞吐率
默认情况下,Nginx Worker 进程可能被内核调度到任意 CPU 核心上,造成频繁上下文切换和缓存失效。启用 worker_cpu_affinity 可将每个 Worker 绑定到指定核心,减少跨核迁移开销,显著提升 cache locality 和事件处理效率。例如:
- 4 核 CPU 配置 4 个 Worker 并一一绑定(如
worker_cpu_affinity 0001 0010 0100 1000;) - 避免设置过多 Worker(如 16 个 Worker 跑在 4 核机器上),否则竞争加剧,反而降低吞吐
单 Worker 内事件处理无锁、零阻塞是高吞吐关键
每个 Worker 使用异步非阻塞 I/O,在单线程事件循环中完成 accept → read → parse → write → close 全流程。它不依赖多线程同步,也无需锁保护连接状态,因此:
- 避免了线程切换和锁争用带来的延迟,尤其在高并发短连接场景下优势明显
- 吞吐率主要受限于单核性能(CPU、内存带宽、网卡中断处理能力),而非进程/线程数量本身
- 若业务逻辑嵌入阻塞调用(如同步 DNS 查询、慢磁盘读取),会卡住整个 Worker 的事件循环,吞吐断崖下跌
连接分配策略影响实际负载均衡与吞吐上限
Worker 间连接并非自动均分。accept_mutex 默认开启时,Worker 通过共享内存锁竞争 accept 新连接,避免“惊群”,但也会引入轻量级串行化;关闭后可能提升吞吐(尤其在高新建连接率场景),但需配合 reuseport(Linux 3.9+)由内核分发连接,才能真正实现多 Worker 并行 accept:
- 启用
reuseport(在 listen 指令后加reuseport)后,内核按 hash 将新连接直接分发到不同 Worker,消除 accept 锁瓶颈 - 此时吞吐更接近各 Worker 吞吐之和,实测在万级 QPS 场景下可提升 20%–40%
真实吞吐还取决于上下游协同能力
Worker 独立处理事件只是基础,最终吞吐率受制于最慢一环:
- 上游:客户端建连速率、TCP 窗口、RTT;反向代理场景下后端服务响应延迟和连接池大小
- 下游:磁盘 IO(如 access_log 开启 buffer 与 flush)、SSL 握手开销(ECDSA 替代 RSA、session reuse)、gzip 压缩是否启用 worker 进程级缓存
- 监控指标应关注每个 Worker 的
Active connections分布、Reading/Writing/Waiting状态比例,而非仅看总连接数














