


轮询本身不解决单点故障,真正起作用的是Nginx反向代理层的高可用设计;需将Nginx自身集群化,并配合健康检查(如proxy_next_upstream、max_fails等)和VIP漂移或云负载均衡来消除单点。
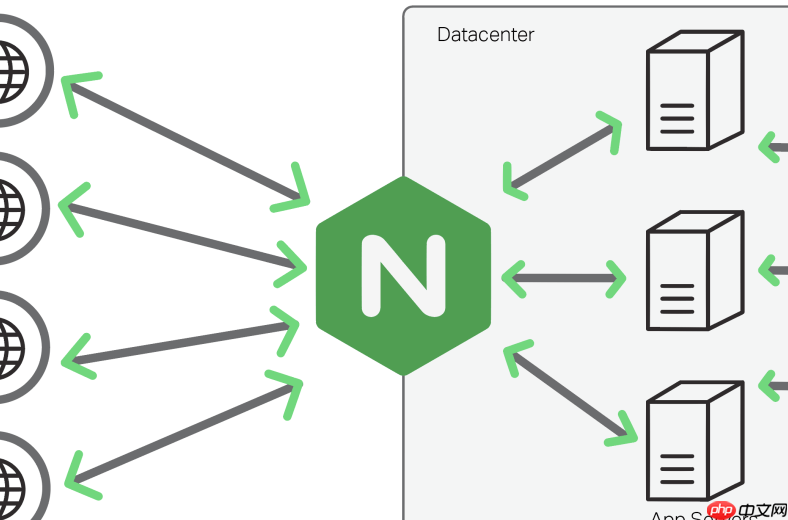
轮询模式本身不解决单点故障,真正起作用的是Nginx作为反向代理层的高可用设计——你需要把Nginx自身也做成集群,而不是依赖单台Nginx服务器。
轮询只是分发逻辑,不是容错机制
轮询(round-robin)是Nginx默认的负载均衡策略,它按顺序把请求分给后端服务器,但不检测后端是否存活。如果某台后端宕机,Nginx默认仍会把请求发过去,直到超时失败。要让轮询“智能”起来,必须配合健康检查:
- 启用
proxy_next_upstream,例如proxy_next_upstream error timeout http_500;,让失败请求自动转给下一台 - 配置
health_check(需使用 Plus 版本)或通过check指令(需安装第三方模块 nginx-upstream-check-module)主动探测后端状态 - 设置合理的
fail_timeout和max_fails,比如max_fails=3 fail_timeout=30s,避免频繁误判
Nginx自身才是真正的单点
即使后端服务做了集群,如果只用一台Nginx做入口,它一挂,整个系统就不可用。解决方法不是优化轮询,而是消除Nginx单点:
- 部署至少两台Nginx服务器,前端用 Keepalived + VRRP 实现虚拟IP(VIP)漂移,主节点故障时VIP自动切到备节点
- 在云环境中,可直接用云厂商的负载均衡器(如阿里云SLB、AWS ALB)替代自建Nginx,由平台保障接入层高可用
- 若用Kubernetes,用 Ingress Controller(如nginx-ingress)配合多副本和Service类型为LoadBalancer或NodePort,底层由集群调度保障
配置示例:带基础健康检查的轮询
以下是一个生产中更健壮的轮询配置片段(无需额外模块):
upstream backend {
    server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.12:8080 max_fails=3 fail_timeout=30s;
}

server {
    location / {
        proxy_pass http://backend;
        proxy_next_upstream error timeout http_500 http_502 http_503 http_504;
        proxy_next_upstream_tries 3;
        proxy_next_upstream_timeout 5s;
    }
}
注意:proxy_next_upstream 是请求级重试,不是连接池级;它不能代替上游主动探活,仅作为兜底。
进阶建议:别只盯着轮询
轮询适合后端能力均等、无状态的场景。实际中可结合业务特点选更合适的策略:
- 用
ip_hash保证同一客户端固定到同一台后端(适用于有简单会话粘性的老系统) - 用
least_conn把请求优先交给当前连接数最少的后端,更适合长连接或响应时间差异大的情况 - 用
hash $request_uri consistent;实现一致性哈希,适合缓存类服务,提升缓存命中率
所有这些策略都建立在Nginx自身高可用的基础上,否则再好的调度算法也无从生效。











