








504 Gateway Timeout 是 Nginx 作为反向代理等待后端响应超时所致,需先确认是后端真实延迟还是 Nginx 超时设置过短;应合理调整 proxy_connect_timeout、proxy_send_timeout 和 proxy_read_timeout,并结合日志、监控与后端优化根治问题。
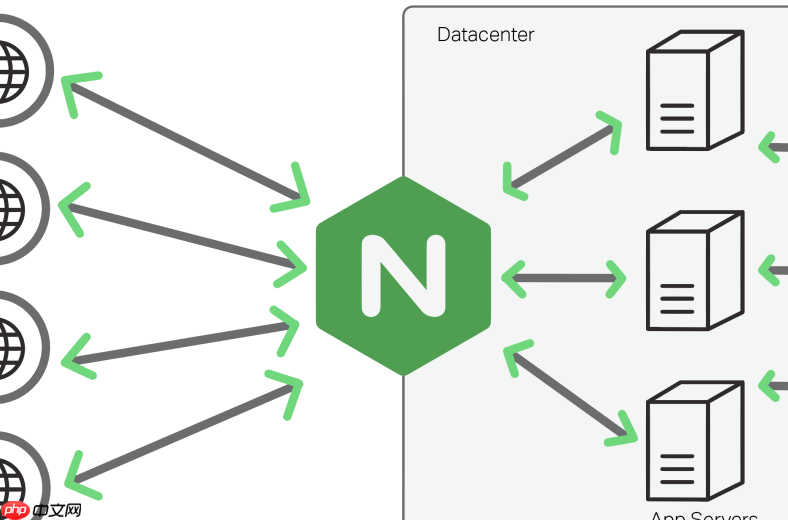
504 Gateway Timeout 通常不是 Nginx 自身的问题,而是它作为反向代理,在等待后端(如 PHP-FPM、Node.js、Java 应用等)响应时超时了。关键要区分:是后端真慢,还是 Nginx 等待时间设得太短?
检查并合理设置 Nginx 超时参数
Nginx 默认的超时值偏保守(比如 proxy_read_timeout 默认 60 秒),面对复杂查询或高负载后端容易触发 504。需根据业务实际调整:
- proxy_connect_timeout:Nginx 连接后端的超时,一般设为 5–10 秒足够
- proxy_send_timeout:Nginx 向后端发请求的超时,通常 30–60 秒
-
proxy_read_timeout:Nginx 等待后端响应的超时,这是最常需调大的项;若后端慢查询最长约 120 秒,可设为
180
这些配置需放在 location 或 server 块中,例如:
location /api/ {
    proxy_pass http://backend;
    proxy_connect_timeout 10;
    proxy_send_timeout 60;
    proxy_read_timeout 180;
}
确认慢查询是否真来自后端
别急着调大超时——先验证问题根源:
- 直接 curl 后端服务(绕过 Nginx),看响应时间是否一致;若也超 180 秒,说明是应用或数据库瓶颈
- 查 Nginx access log,用
$upstream_response_time字段确认后端实际耗时(如0.002 128.456 0.001表示三次重试中第二次花了 128 秒) - 结合后端日志或 APM 工具(如 SkyWalking、Pinpoint),定位具体接口或 SQL
优化后端而非只延长超时
单纯调大 proxy_read_timeout 只是掩盖问题,还可能引发连接堆积、雪崩。更可持续的做法:
- 对慢接口做异步化改造:返回任务 ID,前端轮询或 WebSocket 推送结果
- 加缓存层(Redis/Memcached)减少重复计算和 DB 查询
- 数据库侧优化:添加缺失索引、拆分大表、重写低效 SQL、读写分离
- 限流降级:用 Nginx 的
limit_req或后端熔断机制,防止慢查询拖垮整个服务
补充:Nginx 日志与监控建议
让问题可追溯:
- 在 log_format 中加入
$upstream_status $upstream_response_time $upstream_http_x_request_id,便于关联追踪 - 用 Prometheus + nginx-vts-exporter 或官方 nginx-module-vts 监控 upstream 状态码分布和响应延迟 P95/P99
- 对 504 频次设置告警(如 5 分钟内 >5 次),避免人工发现滞后

















