





Nginx原生不支持主动健康检查,仅通过请求失败被动摘除后端并依超时试探恢复;需第三方模块(如nginx_upstream_check_module)或外部工具(Consul、OpenResty等)实现主动探测。
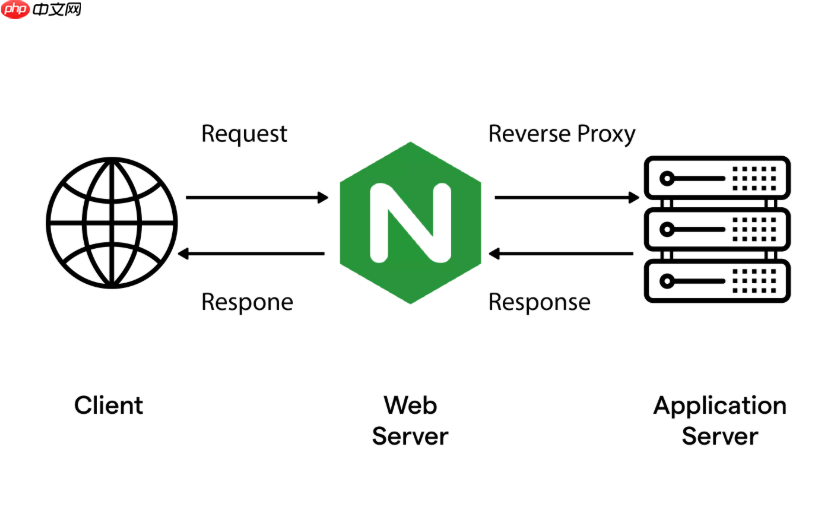
Nginx 本身不通过“事件循环”主动轮询后端健康状态,它的健康检查机制是被动触发、基于请求的,或依赖第三方模块(如 nginx_upstream_check_module)实现主动探测。原生 Nginx 的 upstream 模块默认只做故障隔离(failover),而非持续健康检查。
原生 Nginx 的“伪健康检查”:失败重试 + 被动摘除
标准 Nginx 不维护后台定时任务扫描后端,而是依靠以下行为间接实现容错:
-
请求失败时标记服务器为不可用:当某次代理请求返回错误(如 502/503/超时),Nginx 会按
max_fails和fail_timeout参数临时将该后端标记为 down; -
自动恢复需等待超时后试探:在
fail_timeout时间过后,Nginx 会将首个新请求发给该后端——若成功则重新启用,失败则继续禁用; - 无独立事件循环驱动探测:整个过程没有后台线程或事件循环持续 ping 或 GET 健康接口,完全依附于用户请求流。
要实现主动健康检查,需引入扩展模块
常见做法是编译安装开源模块 nginx_upstream_check_module(由淘宝团队开发,已广泛用于 Tengine 和部分 Nginx 发行版):
- 支持周期性 TCP 连接、HTTP HEAD/GET 请求探测后端;
- 可配置检查间隔、超时、成功/失败阈值,并提供
/status接口实时查看状态; - 其内部使用 Nginx 的事件机制(epoll/kqueue)调度探测任务,但并非传统 Node.js 风格的单线程事件循环,而是基于 master-worker 模型中 worker 进程的定时器 + I/O 多路复用协作完成。
替代方案:外部工具协同实现健康感知
更现代、解耦的做法是绕过 Nginx 内置逻辑,交由外部系统管理:
- 用 Consul、etcd 或 Nacos 维护服务注册与健康心跳,Nginx Plus 可直接集成这些服务发现后端;
- 通过 Lua(OpenResty)编写自定义健康探测逻辑,在
init_worker_by_lua*中启动定时协程,结合ngx.timer.at实现轻量级主动检查; - 配合脚本定期调用后端健康接口,更新 Nginx 配置并 reload(适合低频变更场景,注意 reload 开销)。
关键提醒:避免误解“事件循环”的角色
Nginx 的高性能源于异步非阻塞 I/O 和多路复用(如 epoll),但它不是以“事件循环”为核心抽象来设计健康检查功能的。它的核心哲学是:尽量减少后台开销,把决策绑定到真实流量上。所谓“利用事件循环做健康检查”,其实是混淆了底层 I/O 模型与上层功能设计——真正的主动检查必须显式引入额外逻辑或模块。














