随着全球智能计算集群规模迈入“万卡时代”,并加速向“十万卡”级别迈进,传统单机八卡服务器在训练超万亿参数大模型时,受限于高昂的集群通信开销,难以实现算力的线性扩展。技术演进重心正快速转向具备超强互联能力的超节点架构。
近日,依托OISA协同创新平台,摩尔线程、中国移动研究院、之江实验室等产业伙伴联合推出《OISA高密超节点参考设计技术规范》。该规范直面当前智算中心在高速互联、高功率供电及极限散热等方面的核心挑战,提出覆盖硬件、协议、能效全栈的一体化解决方案,为打造自主可控、高性能的新一代智算基础设施提供了关键支撑。
重构互联范式,驱动算力密度跃升新高度
在智算中心的空间部署与网络拓扑层面,OISA高密超节点通过物理密度与逻辑扩展维度的双重突破,有效破解传统架构下的算力增长瓶颈。技术规范率先采用大尺寸高带宽线缆方案,在主流32卡至64卡全互联基础上,首次实现标准单宽机柜内128卡无阻塞互联,并支持并柜扩展至256卡规模,显著提升单位面积算力产出效率。在核心通信协议方面,基于OISA 2.0原生内存语义能力,该设计达成跨节点统一地址空间访问;叠加自研报文精简与重构机制,卡间互连带宽突破TB/s量级,端到端时延压缩至数百纳秒区间。这一“超高物理集成度+超低延迟逻辑互联”的融合创新,不仅兼容多厂商国产AI芯片,更构建出接近单机体验的大规模协同训练环境。
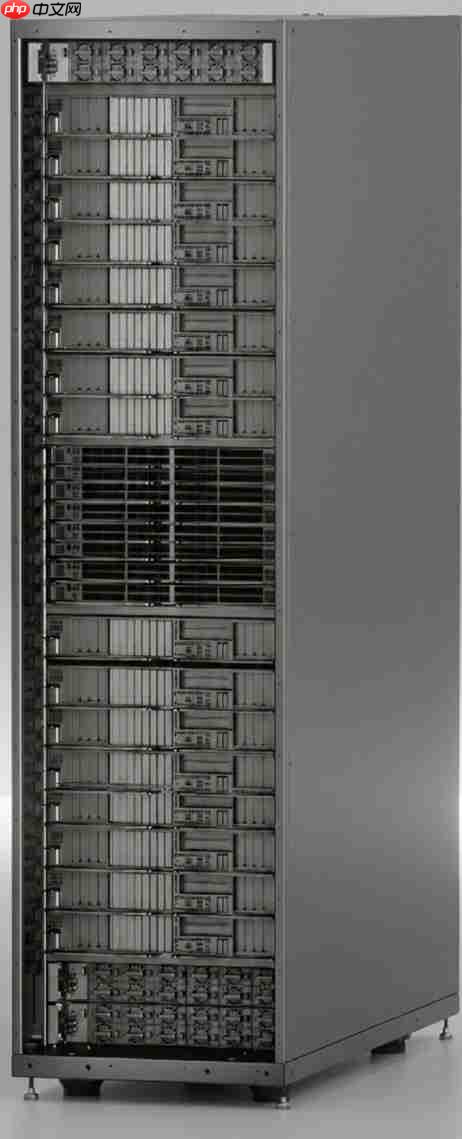
OISA高密超节点参考设计
供电与散热双轨升级,打造极简低碳底座

面对GPU单芯功耗突破700W、整柜功率逼近甚至超越350kW的发展趋势,OISA参考设计在供电系统与热管理层面完成底层重构。供电方面,方案全面引入高压直流(HVDC)配电架构,结合柜内集中式供电与盲插快接技术,大幅削减电力转换环节,降低传输损耗,为超级AI数据中心提供高稳定、高效率的能量供给。
散热方面,液冷技术由可选配置升级为架构原生能力,围绕单GPU超2kW的热密度需求进行深度定制优化,推动PUE值从传统风冷时代的1.4降至1.05~1.15区间。借助对流速、压力、温度等参数的全链路实时感知与智能诊断系统,该方案在导热效率提升数千倍的同时,保障了系统在持续高负载下的长期可靠性,也为智算产业迈向绿色低碳发展铺就坚实路径。
共建开放协同生态,推动智算产业高质量跃迁
OISA高密超节点参考设计的正式发布,是产业链各方凝聚共识、深化协同创新的重要成果,标志着我国智算基础设施建设正从分散试错走向体系化、标准化协同发展的新阶段。该规范通过整合芯片、设备、软件、应用等全链条资源,构建更具包容性与普适性的算力生态,依托芯片、整机、算法等多环节深度耦合,为行业提供更丰富、更具抗风险能力的技术演进选项。
面向未来,OISA协同创新平台将持续坚持开放、协作、共赢理念,加速融合Chiplet异构集成、光互连、内存池化等前沿技术方向,携手合作伙伴不断逼近计算性能边界。以中国移动、之江实验室等为代表的生态力量,将持续拓展合作网络,广泛吸纳开发者参与场景化、定制化方案共建,在开放中激发创新活力,在协同中释放技术价值,合力擘画高效、绿色、可持续的智能计算发展新图景。