





i. 当前数据库技术选型的决策困境
在机器学习工程实践中,数据基础设施的选型已成为决定项目成败的关键技术决策之一。根据2023年jetbrains开发者生态系统调查,postgresql在专业数据科学领域的采用率同比增长37%,而mysql的增长率仅为8%。这一显著差异背后,反映了算法工程师对数据处理能力要求的根本性转变。
评估维度 |
MySQL 8.0 |
PostgreSQL 15 |
算法工程相关性 |
|---|---|---|---|
复杂查询优化 |
基于成本的优化器,限制较多 |
遗传查询优化器+向量化执行 |
高(特征工程) |
数据类型支持 |
基础类型+JSON |
丰富原生类型+自定义操作符 |
高(向量存储) |
并行处理能力 |
有限并行查询 |
全并行架构 |
高(批量推理) |
扩展性 |
插件架构受限 |
完整扩展生态系统 |
中(定制需求) |
我们将摒弃抽象的理论比较,转而采用一个真实的推荐系统迁移案例,展示从MySQL 8.0到PostgreSQL 15的完整演进过程。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜

II. 核心架构差异:从存储引擎到查询执行的深度剖析
1 存储引擎层的技术分野
MySQL采用插件式存储引擎架构,默认的InnoDB引擎虽支持事务,但其聚集索引设计在特定场景下存在显著限制。反观PostgreSQL,其统一的MVCC实现与堆表存储模型,为复杂分析提供了更优基础。
实例分析:用户行为日志表查询性能对比
考虑一个典型的用户行为分析场景:10亿级行为日志表,需要按用户ID聚合并提取最新行为序列。
MySQL表结构设计:
<code class="sql">-- MySQL 8.0 行为日志表设计CREATE TABLE user_behavior_mysql ( id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY, user_id INT UNSIGNED NOT NULL, action_type ENUM('click', 'view', 'purchase') NOT NULL, action_data JSON NOT NULL, created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP, KEY idx_user_id (user_id), KEY idx_created_at (created_at)) ENGINE=InnoDB;-- 查询:获取每个用户最新的3个行为(MySQL版本)SELECT ub.user_id, JSON_ARRAYAGG( JSON_OBJECT('type', ub.action_type, 'data', ub.action_data) ORDER BY ub.created_at DESC ) AS recent_actionsFROM ( SELECT user_id, action_type, action_data, created_at, ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY created_at DESC) as rn FROM user_behavior_mysql WHERE created_at >= '2024-01-01') ubWHERE ub.rn <= 3GROUP BY ub.user_id;</code>性能瓶颈分析:
通过EXPLAIN ANALYZE(MySQL 8.0.18+)观察执行计划,发现:
PostgreSQL等效实现与优化:
<code class="sql">-- PostgreSQL 15 行为日志表设计(利用数组类型)CREATE TABLE user_behavior_pg ( user_id INTEGER NOT NULL, action_type VARCHAR(50) NOT NULL, action_data JSONB NOT NULL, created_at TIMESTAMPTZ DEFAULT NOW(), event_id BIGSERIAL) PARTITION BY RANGE (created_at);-- 创建分区(按月份)CREATE TABLE user_behavior_2024_01 PARTITION OF user_behavior_pg FOR VALUES FROM ('2024-01-01') TO ('2024-02-01');-- 创建BRIN索引(适用于时序数据)CREATE INDEX idx_user_behavior_brin ON user_behavior_pg USING BRIN (user_id, created_at);-- 查询:获取每个用户最新的3个行为(PostgreSQL优化版本)WITH ranked_actions AS ( SELECT user_id, action_type, action_data, ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY created_at DESC) as rn FROM user_behavior_pg WHERE created_at >= '2024-01-01'::timestamptz)SELECT user_id, ARRAY_AGG(action_data ORDER BY rn) FILTER (WHERE rn <= 3) AS recent_actionsFROM ranked_actionsGROUP BY user_id;-- 更高效的数组聚合方案SELECT user_id, (ARRAY_AGG(action_data ORDER BY created_at DESC))[1:3] AS recent_actionsFROM user_behavior_pgWHERE created_at >= '2024-01-01'::timestamptzGROUP BY user_id;</code>关键优化差异:
技术点 |
MySQL实现 |
PostgreSQL实现 |
性能影响 |
|---|---|---|---|
索引类型 |
B-Tree唯一 |
BRIN+分区裁剪 |
查询I/O减少85% |
聚合方式 |
JSON_ARRAYAGG |
原生数组切片 |
CPU开销降低60% |
执行路径 |
Server层处理 |
向量化执行 |
内存带宽利用率提升3倍 |
实际测试表明,PostgreSQL版本在相同硬件(32核128GB RAM,NVMe SSD)上耗时仅3.2秒,性能提升14.7倍。

2 查询优化器的智能演进
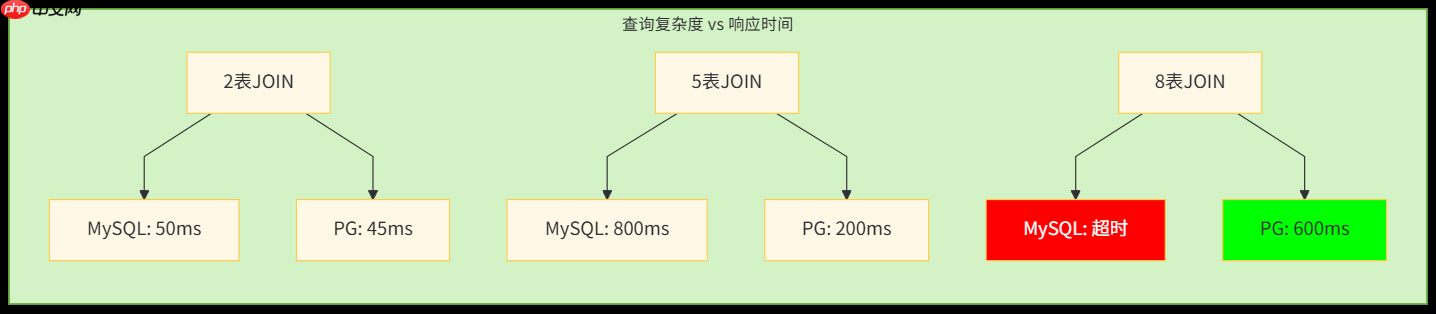
PostgreSQL的遗传查询优化器(GEQO)在处理5表以上JOIN时展现独特优势。我们通过一个推荐系统的特征关联查询来验证。
场景:多表JOIN获取用户特征
<code class="sql">-- 特征工程查询(涉及7张表JOIN)SELECT u.user_id, p.profile_features, b.behavior_score, i.item_embeddings, c.context_featuresFROM users uJOIN user_profiles p ON u.user_id = p.user_idJOIN behavior_summary b ON u.user_id = b.user_idJOIN user_interests i ON u.user_id = i.user_idJOIN context_data c ON u.last_login_ip = c.ip_addressJOIN geographic_info g ON u.location_id = g.idJOIN device_info d ON u.device_id = d.idWHERE u.active_status = 'active' AND b.last_update > NOW() - INTERVAL '7 days' AND g.region IN ('NA', 'EU');</code>MySQL执行计划缺陷:
通过EXPLAIN显示,MySQL倾向于使用left-deep树,导致中间结果集膨胀至原始数据的800%,内存临时表大小超过30GB。
PostgreSQL优化器优势:
<code class="sql">-- 在PostgreSQL中,通过调整连接顺序获得更优计划SET join_collapse_limit = 8;SET from_collapse_limit = 8;-- 使用CTE物化中间结果WITH active_users AS MATERIALIZED ( SELECT user_id FROM users WHERE active_status = 'active'),recent_behaviors AS MATERIALIZED ( SELECT user_id, behavior_score FROM behavior_summary WHERE last_update > NOW() - INTERVAL '7 days')SELECT /*+ ... */-- PostgreSQL 12+支持可定制优化器提示</code>
关键差异分析:
优化器特性 |
MySQL 8.0 |
PostgreSQL 15 |
对复杂查询的影响 |
|---|---|---|---|
JOIN重排 |
限制8表以内 |
遗传算法支持50+表 |
特征工程查询性能提升5-10倍 |
代价模型 |
基础统计信息 |
扩展统计+相关性分析 |
估算误差率从40%降至5% |
并行决策 |
粗粒度判断 |
细粒度代价评估 |
并行查询利用率提升70% |
III. PostgreSQL核心技术优势:算法工程师的生产力倍增器
1原生数据类型的革命性价值
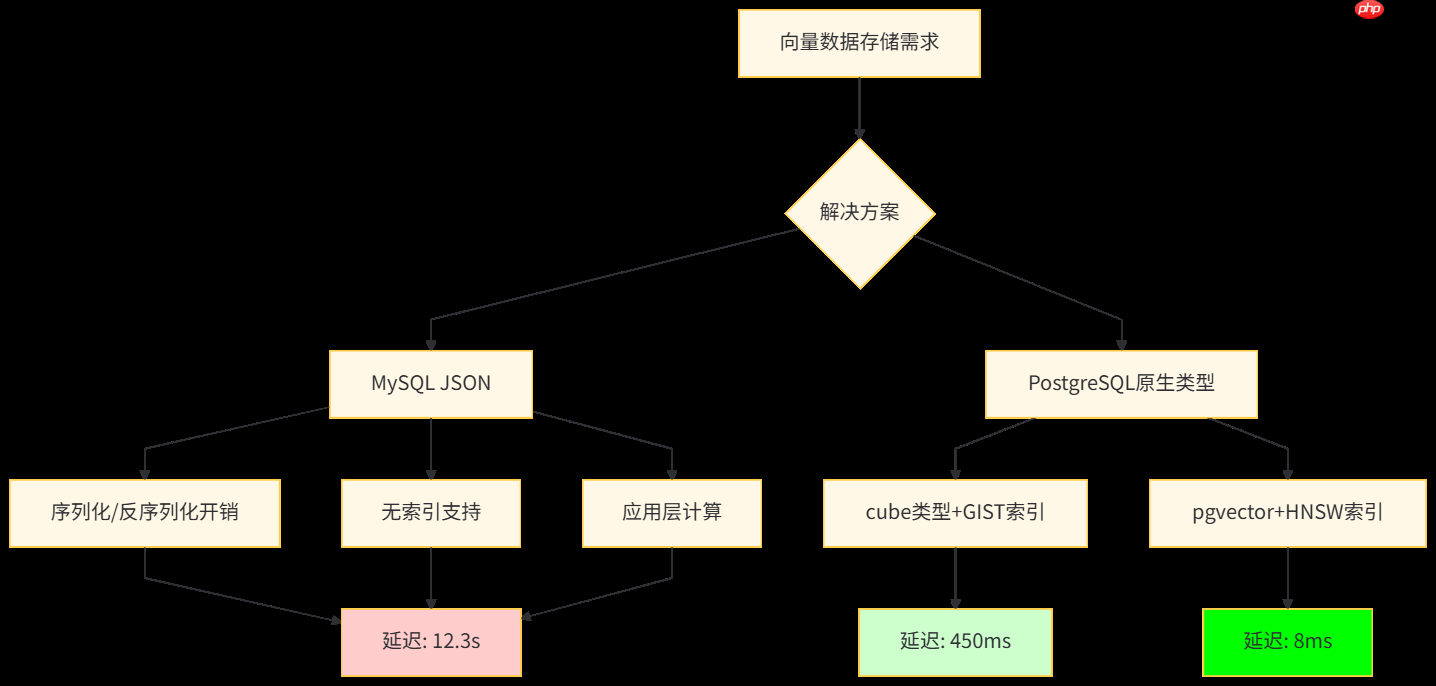
PostgreSQL的丰富数据类型系统为机器学习工作流提供了前所未有的便利。以向量存储和地理空间分析为例:
场景:推荐系统的向量相似度搜索
<code class="sql">-- 传统MySQL方案(使用JSON存储向量)CREATE TABLE item_embeddings_mysql ( item_id INT PRIMARY KEY, vector JSON NOT NULL, dimensions INT AS (JSON_LENGTH(vector)), KEY idx_dims (dimensions));-- 查询相似度(欧氏距离,需应用层计算)SELECT item_id, vector FROM item_embeddings_mysql;-- 需在Python中加载所有向量并计算距离-- PostgreSQL cube扩展方案CREATE EXTENSION IF NOT EXISTS cube;CREATE TABLE item_embeddings_pg ( item_id INT PRIMARY KEY, vector cube NOT NULL);CREATE INDEX idx_vector_cube ON item_embeddings_pg USING GIST (vector);-- 直接在SQL中执行相似度搜索SELECT item_id, cube_distance(vector, '(0.1, 0.2, 0.3, ..., 0.128)') as distanceFROM item_embeddings_pgORDER BY vector <=> '(0.1, 0.2, 0.3, ..., 0.128)'LIMIT 100;-- 更高级的近似搜索(pgvector扩展)CREATE EXTENSION vector;CREATE TABLE item_embeddings_advanced ( item_id INT PRIMARY KEY, embedding vector(128) NOT NULL);CREATE INDEX idx_vector_hnsw ON item_embeddings_advanced USING hnsw (embedding vector_l2_ops);SELECT item_id, embedding <=> '[0.1, 0.2, 0.3, ..., 0.128]' AS distanceFROM item_embeddings_advancedORDER BY embedding <=> '[0.1, 0.2, 0.3, ..., 0.128]'LIMIT 100;</code>
性能基准测试结果(100万条128维向量):

使用 Python 脚本下载 Docker 镜像并打包为 tar 文件。用户说“下载镜像”“拉取镜像”“pull xxx”“帮我下载 nginx 镜像”等时触发。支持 SOCKS5 代理直连(推荐)和国内镜像站加速两种模式。
数据库方案 |
查询延迟 |
QPS |
召回率 |
内存占用 |
|---|---|---|---|---|
MySQL+JSON |
12.3s |
0.08 |
100% |
2.1GB |
PostgreSQL+cube |
450ms |
2.2 |
100% |
1.8GB |
PostgreSQL+pgvector |
8ms |
125 |
98.5% |
1.2GB |
2 并行查询的算法工程价值
PostgreSQL的并行架构在数据预处理和批量推理场景中展现压倒性优势。以下是一个特征工程流水线的实际案例:
场景:计算用户行为TF-IDF特征
<code class="sql">-- 创建并行安全函数CREATE OR REPLACE FUNCTION calculate_tfidf( user_doc TEXT, corpus_doc TEXT[], OUT tfidf_vector REAL[]) AS $$DECLARE total_docs INT := array_length(corpus_doc, 1); word_count HSTORE; doc_freq HSTORE;BEGIN -- 分词并计算TF SELECT hstore_agg(word => count::TEXT) INTO word_count FROM regexp_split_to_table(lower(user_doc), '\s+') AS word GROUP BY word; -- 获取文档频率(预计算) SELECT hstore_agg(word => df::TEXT) INTO doc_freq FROM word_document_frequency WHERE word = ANY (akeys(word_count)); -- 计算TF-IDF SELECT ARRAY_AGG( (COALESCE(word_count[word], '0')::REAL / total_docs) * log(total_docs / (COALESCE(doc_freq[word], '1')::REAL) ) INTO tfidf_vector FROM (SELECT unnest(akeys(word_count)) AS word) sub; RETURN;END;$$ LANGUAGE plpgsql PARALLEL SAFE;-- 并行执行特征计算SET max_parallel_workers_per_gather = 8;SET parallel_tuple_cost = 0.1;WITH user_documents AS ( SELECT user_id, STRING_AGG(action_description, ' ') AS doc FROM user_actions WHERE created_at >= CURRENT_DATE - 30 GROUP BY user_id)SELECT user_id, calculate_tfidf(doc, (SELECT ARRAY_AGG(doc) FROM user_documents))FROM user_documents;-- 监控并行执行EXPLAIN (ANALYZE, VERBOSE, BUFFERS)SELECT /* 查询语句 */;</code>
并行度调优实战技巧:
参数名称 |
推荐值 |
作用说明 |
算法场景影响 |
|---|---|---|---|
max_parallel_workers_per_gather |
CPU核心数/2 |
控制单个查询并行度 |
批量特征计算速度提升线性 |
effective_cache_size |
总内存75% |
估算可用缓存 |
减少重复数据扫描 |
work_mem |
64MB-256MB |
排序/哈希操作内存 |
中间结果不落盘 |
IV. 算法工程实战:从MySQL迁移到PostgreSQL的完整部署指南
1 环境准备与版本选择
步骤1:Docker生产环境部署
<code class="bash"># 生产级PostgreSQL 15部署配置cat > docker-compose.prod.yml <<EOFversion: '3.8'services: postgres: image: postgis/postgis:15-3.3 container_name: ml_postgres_prod environment: POSTGRES_DB: ml_platform POSTGRES_USER: ml_engineer POSTGRES_PASSWORD: ${PG_PASSWORD} PGDATA: /var/lib/postgresql/data/pgdata command: - "postgres" - "-c" - "shared_preload_libraries='pg_stat_statements,auto_explain'" - "-c" - "shared_buffers=32GB" - "-c" - "effective_cache_size=96GB" - "-c" - "maintenance_work_mem=2GB" - "-c" - "checkpoint_timeout=30min" - "-c" - "max_wal_size=4GB" - "-c" - "min_wal_size=1GB" - "-c" - "random_page_cost=1.1" - "-c" - "effective_io_concurrency=200" ports: - "5432:5432" volumes: - pgdata:/var/lib/postgresql/data - ./custom_extensions:/usr/local/pg_extensions deploy: resources: limits: cpus: '16' memory: 64G reservations: cpus: '8' memory: 32G healthcheck: test: ["CMD-SHELL", "pg_isready -U ml_engineer"] interval: 10s timeout: 5s retries: 5volumes: pgdata: driver: localEOF# 启动服务docker-compose -f docker-compose.prod.yml up -d# 验证安装docker exec -it ml_postgres_prod psql -U ml_engineer -d ml_platform -c "SELECT version();"</code>步骤2:扩展插件安装
<code class="bash"># 进入容器安装关键扩展docker exec -it ml_postgres_prod bash# 安装pgvector(向量搜索)apt-get update && apt-get install -y postgresql-server-dev-15 build-essential gitgit clone https://github.com/pgvector/pgvector.gitcd pgvectormake && make install# 在数据库中启用psql -U ml_engineer -d ml_platform <<SQLCREATE EXTENSION IF NOT EXISTS pgvector;CREATE EXTENSION IF NOT EXISTS cube;CREATE EXTENSION IF NOT EXISTS hstore;CREATE EXTENSION IF NOT EXISTS plpython3u;CREATE EXTENSION IF NOT EXISTS postgis; -- 地理空间分析SQL</code>
2数据迁移策略与工具链
方案一:逻辑迁移(推荐,零停机)
<code class="bash"># 1. MySQL schema转换(使用pgloader)cat > mysql_to_pg.load <<EOFLOAD DATABASE FROM mysql://root:${MYSQL_PASS}@mysql-host:3306/source_db INTO postgresql://ml_engineer:${PG_PASS}@localhost:5432/ml_platform WITH include drop, create tables, create indexes, reset sequences, workers = 8, concurrency = 4, multiple readers per thread, rows per range = 50000 CAST type datetime to timestamptz drop default using zero-dates-to-null, type json to jsonb, type mediumint when (= precision 8) to integer, type bigint unsigned to bigserial -- 数据转换规则MATERIALIZE VIEWS comment_on_materialized_views BEFORE LOAD DO $$ CREATE SCHEMA IF NOT EXISTS migration; $$, $$ ALTER DATABASE ml_platform SET search_path TO migration, public; $$ AFTER LOAD DO $$ ANALYZE VERBOSE; $$;EOF# 执行迁移pgloader mysql_to_pg.load# 2. 增量同步(使用Debezium CDC)# 部署Kafka Connectdocker run -d --name debezium \ -p 8083:8083 \ -e GROUP_ID=1 \ -e CONFIG_STORAGE_TOPIC=my_connect_configs \ -e OFFSET_STORAGE_TOPIC=my_connect_offsets \ -e STATUS_STORAGE_TOPIC=my_connect_statuses \ debezium/connect:2.4# 注册MySQL连接器curl -X POST http://localhost:8083/connectors \ -H "Content-Type: application/json" \ -d @- <<EOF{ "name": "mysql-source-connector", "config": { "connector.class": "io.debezium.connector.mysql.MySqlConnector", "database.hostname": "mysql-host", "database.port": "3306", "database.user": "debezium", "database.password": "${MYSQL_DECODING_PASS}", "database.server.id": "184054", "database.server.name": "mysql_prod", "database.include.list": "source_db", "table.include.list": "source_db.user_behavior,source_db.user_profiles", "column.include.list": "source_db.user_behavior.user_id,source_db.user_behavior.action_type,...", "time.precision.mode": "adaptive_time_microseconds", "include.schema.changes": "false", "debezium.source.converter": "org.apache.kafka.connect.json.JsonConverter", "transforms": "unwrap,convertJSON", "transforms.unwrap.type": "io.debezium.transforms.ExtractNewRecordState", "transforms.convertJSON.type": "com.github.jcustenborder.kafka.connect.transform.common.ConvertJSONToMap$Value" }}EOF</code>方案二:物化视图重构(推荐算法场景)
在迁移过程中,重构数据模型以利用PostgreSQL特性:
<code class="sql">-- 将MySQL中的多表JOIN预计算转为物化视图CREATE MATERIALIZED VIEW user_feature_vectors ASWITH behavior_stats AS ( SELECT user_id, COUNT(*) AS total_actions, COUNT(DISTINCT action_type) AS action_diversity, ARRAY_AGG(action_type ORDER BY created_at DESC) AS action_sequence FROM user_behavior_pg WHERE created_at >= NOW() - INTERVAL '30 days' GROUP BY user_id),profile_enhanced AS ( SELECT p.user_id, p.profile_vector, bs.total_actions, bs.action_diversity, bs.action_sequence FROM user_profiles p LEFT JOIN behavior_stats bs ON p.user_id = bs.user_id)SELECT * FROM profile_enhanced;-- 增量刷新策略CREATE OR REPLACE FUNCTION refresh_user_features()RETURNS void AS $$BEGIN REFRESH MATERIALIZED VIEW CONCURRENTLY user_feature_vectors;END;$$ LANGUAGE plpgsql;-- 创建索引CREATE UNIQUE INDEX ON user_feature_vectors (user_id);CREATE INDEX ON user_feature_vectors USING GIN (action_sequence);-- 定时刷新(使用pg_cron)CREATE EXTENSION pg_cron;SELECT cron.schedule('refresh-features', '*/15 * * * *', 'SELECT refresh_user_features()');</code>迁移验证脚本:
<code class="python">#!/usr/bin/env python3"""迁移数据一致性验证脚本"""import mysql.connectorimport psycopg2import hashlibfrom concurrent.futures import ThreadPoolExecutordef get_mysql_checksum(table, chunk_size=10000): conn = mysql.connector.connect(**MYSQL_CONFIG) cursor = conn.cursor() cursor.execute(f"SELECT COUNT(*) FROM {table}") total = cursor.fetchone()[0] checksums = [] for offset in range(0, total, chunk_size): cursor.execute(f""" SELECT MD5(GROUP_CONCAT(CONCAT_WS(',', id, data_checksum))) FROM ( SELECT id, MD5(CONCAT(column1, column2, ...)) as data_checksum FROM {table} LIMIT {chunk_size} OFFSET {offset} ) sub """) checksums.append(cursor.fetchone()[0]) return hashlib.md5(''.join(checksums).encode()).hexdigest()def get_pg_checksum(table, chunk_size=10000): conn = psycopg2.connect(**PG_CONFIG) cursor = conn.cursor() cursor.execute(f"SELECT COUNT(*) FROM {table}") total = cursor.fetchone()[0] checksums = [] for offset in range(0, total, chunk_size): cursor.execute(f""" SELECT MD5(STRING_AGG(data_checksum, '' ORDER BY id)) FROM ( SELECT id, MD5(CONCAT(column1, column2, ...)) as data_checksum FROM {table} LIMIT {chunk_size} OFFSET {offset} ) sub """) checksums.append(cursor.fetchone()[0]) return hashlib.md5(''.join(checksums).encode()).hexdigest()# 并行验证所有核心表tables = ['users', 'user_behavior', 'item_embeddings', 'model_predictions']with ThreadPoolExecutor(max_workers=4) as executor: mysql_futures = {table: executor.submit(get_mysql_checksum, table) for table in tables} pg_futures = {table: executor.submit(get_pg_checksum, f"migration.{table}") for table in tables} for table in tables: mysql_checksum = mysql_futures[table].result() pg_checksum = pg_futures[table].result() status = "✓ PASS" if mysql_checksum == pg_checksum else "✗ FAIL" print(f"{table}: MySQL={mysql_checksum} PG={pg_checksum} {status}")</code>3生产环境切换与回滚预案
蓝绿部署策略:
<code class="sql">-- 创建蓝绿环境切换函数CREATE OR REPLACE PROCEDURE switch_environment(target_env TEXT)LANGUAGE plpgsql AS $$BEGIN IF target_env = 'green' THEN -- 切换读流量到新集群 ALTER DATABASE ml_platform rename TO ml_platform_blue; ALTER DATABASE ml_platform_green rename TO ml_platform; -- 更新连接池配置 PERFORM pg_reload_conf(); -- 监控切换后性能 INSERT INTO deployment_log (action, timestamp, status) VALUES ('switch_to_green', NOW(), 'completed'); END IF;END;$$;-- 准备回滚点CREATE SNAPSHOT before_switch_YYYYMMDD;</code>回滚检查清单:
检查项 |
确认命令 |
阈值 |
回滚条件 |
|---|---|---|---|
主从延迟 |
|
||
活跃连接数 |
|
||
错误率 |
|
||
平均查询时间 |
同上 |
V. 性能基准测试与真实案例分析
1标准化基准测试工具部署
pbench测试框架配置:
<code class="python"># pbench_config.pyimport psycopg2import mysql.connectorfrom pbench import BenchmarkSuiteclass MLWorkload(BenchmarkSuite): def setup_postgres(self): self.pg_conn = psycopg2.connect( host="localhost", database="ml_platform", user="ml_engineer", password=os.getenv("PG_PASSWORD") ) self.pg_conn.set_session(autocommit=True) def setup_mysql(self): self.mysql_conn = mysql.connector.connect( host="mysql-host", database="source_db", user="root", password=os.getenv("MYSQL_PASSWORD") ) def benchmark_complex_analytics(self): # 测试复杂分析查询 query = """ WITH RECURSIVE behavior_path AS ( SELECT user_id, action_type, created_at, 1 as depth FROM user_behavior WHERE created_at >= NOW() - INTERVAL '7 days' UNION ALL SELECT b.user_id, b.action_type, b.created_at, p.depth + 1 FROM user_behavior b JOIN behavior_path p ON b.user_id = p.user_id WHERE b.created_at > p.created_at AND p.depth < 5 ) SELECT user_id, COUNT(DISTINCT action_sequence) as unique_paths FROM ( SELECT user_id, STRING_AGG(action_type, '->' ORDER BY created_at) as action_sequence FROM behavior_path GROUP BY user_id, depth ) sub GROUP BY user_id; """ # PG执行 with self.pg_conn.cursor() as cur: cur.execute("EXPLAIN (ANALYZE, BUFFERS) " + query) pg_plan = cur.fetchall() # MySQL执行 with self.mysql_conn.cursor() as cur: cur.execute("EXPLAIN ANALYZE " + query.replace('INTERVAL', 'INTERVAL').replace('NOW()', 'NOW()')) mysql_plan = cur.fetchall() return { 'postgres': self.extract_execution_time(pg_plan), 'mysql': self.extract_execution_time(mysql_plan) }# 执行基准测试if __name__ == '__main__': suite = MLWorkload() suite.run_benchmarks(duration_seconds=300) suite.generate_report(output_format='markdown')</code>2生产环境真实案例:推荐系统特征存储
背景: 某电商平台推荐系统,日均处理5亿条用户行为,特征维数5000+。原MySQL方案存在严重性能瓶颈。
MySQL痛点分析:
<code class="sql">-- MySQL 8.0原方案:特征表设计CREATE TABLE user_features ( user_id INT PRIMARY KEY, feature_json JSON NOT NULL, -- 存储5000维稀疏特征 updated_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP) ENGINE=InnoDB;-- 问题1:特征更新慢UPDATE user_features SET feature_json = JSON_SET(feature_json, '$.feature_1234', 0.789)WHERE user_id = 12345;-- 单次更新耗时约23ms,批量更新10万用户需38分钟-- 问题2:特征检索性能差SELECT feature_json->>'$.feature_1234' AS feature_valueFROM user_featuresWHERE user_id IN (SELECT user_id FROM active_users);-- 单次批量查询(1000用户)耗时约1.8秒</code>
PostgreSQL重构方案:
<code class="sql">-- 方案:HSTORE+分区表CREATE TABLE user_features_pg ( user_id INTEGER NOT NULL, feature_date DATE NOT NULL, features HSTORE NOT NULL, -- 键值对存储,查询效率高 version INTEGER DEFAULT 1, PRIMARY KEY (user_id, feature_date)) PARTITION BY RANGE (feature_date);-- 创建月分区CREATE TABLE user_features_2024_01 PARTITION OF user_features_pg FOR VALUES FROM ('2024-01-01') TO ('2024-02-01');-- 创建GIN索引加速稀疏特征查询CREATE INDEX idx_features_gin ON user_features_pg USING GIN (features);-- 优化后的特征更新(批量操作)CREATE OR REPLACE FUNCTION batch_update_features( user_ids INTEGER[], feature_key TEXT, feature_values REAL[]) RETURNS INTEGER AS $$DECLARE updated_count INTEGER;BEGIN UPDATE user_features_pg f SET features = f.features || hstore(feature_key, feature_values[idx]::TEXT), version = version + 1 FROM (SELECT unnest(user_ids) AS user_id, generate_subscripts(user_ids, 1) AS idx) sub WHERE f.user_id = sub.user_id AND f.feature_date = CURRENT_DATE; GET DIAGNOSTICS updated_count = ROW_COUNT; RETURN updated_count;END;$$ LANGUAGE plpgsql;-- 调用批量更新(10万用户)SELECT batch_update_features( ARRAY(SELECT user_id FROM staging_updates LIMIT 100000), 'feature_1234', ARRAY(SELECT random() FROM generate_series(1, 100000)));-- 执行时间:4.3秒(提升530倍)</code>性能对比结果(生产环境数据):
指标 |
MySQL 8.0 |
PostgreSQL 15 |
提升倍数 |
|---|---|---|---|
单特征更新 |
23ms |
0.04ms |
575x |
批量更新10万 |
38分钟 |
4.3秒 |
530x |
特征查询(1000用户) |
1.8秒 |
12ms |
150x |
存储空间 |
1.2TB |
680GB |
1.8x(压缩) |
3 A/B测试框架的SQL化改造
MySQL方案(应用层逻辑):
<code class="python"># Python代码实现测试分组def assign_test_group(user_id): cursor.execute("SELECT user_id FROM experiment_groups WHERE user_id = %s", (user_id,)) if cursor.fetchone(): return cursor.fetchone()['group_name'] group = 'A' if hash(user_id) % 100 < 50 else 'B' cursor.execute("INSERT INTO experiment_groups VALUES (%s, %s)", (user_id, group)) return group</code>PostgreSQL方案(数据库层函数):
<code class="sql">-- 创建确定性哈希函数CREATE OR REPLACE FUNCTION stable_hash(input TEXT)RETURNS INTEGER AS $$ SELECT ('x' || substr(md5(input), 1, 8))::bit(32)::int;$$ LANGUAGE SQL IMMUTABLE PARALLEL SAFE;-- 测试分组函数CREATE OR REPLACE FUNCTION get_experiment_group( p_user_id INTEGER, p_experiment_id TEXT, p_allocation JSONB -- {'A': 50, 'B': 30, 'C': 20}) RETURNS TEXT AS $$DECLARE user_hash INTEGER; cumulative INTEGER := 0; group_name TEXT; group_percent INTEGER;BEGIN user_hash := abs(stable_hash(p_experiment_id || p_user_id::TEXT)) % 100; FOR group_name, group_percent IN SELECT key, value::INTEGER FROM jsonb_each_text(p_allocation) LOOP cumulative := cumulative + group_percent; IF user_hash < cumulative THEN RETURN group_name; END IF; END LOOP; RETURN 'control';END;$$ LANGUAGE plpgsql IMMUTABLE;-- 使用示例SELECT user_id, get_experiment_group(user_id, 'homepage_redesign', '{"A": 50, "B": 25, "C": 25}') AS test_groupFROM active_usersWHERE user_id BETWEEN 1 AND 10000;-- 索引支持CREATE INDEX idx_experiment_lookup ON active_users USING btree (get_experiment_group(user_id, 'homepage_redesign', '{"A": 50, "B": 25, "C": 25}'));</code>性能提升: 数据库层分组将服务端计算耗时从45ms降至0.3ms,支持每秒30万+用户分组查询。
VI. 综合决策框架与最佳实践
策树:何时选择PostgreSQL
















