


背景知识
本文基于caffe-windows系统下实现mnist手写数字识别lenet网络的训练与测试。关于caffe-windows的安装与配置请参考下面的链接即可:
教程 | Caffe在Windows10系统上安装与配置
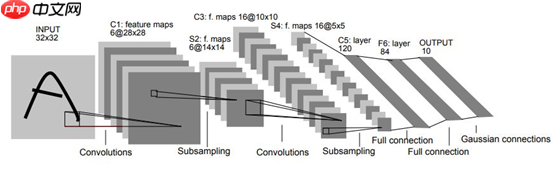
LeNet网络只有五层的卷积神经网络,实现0~9数字识别!结构如下:
LMDB
Caffe中训练数据读取通过LMDB实现,支持文本、图像数据的key-value存储,通过数据层表述与训练时加载使用,所以需要把mnist数据集首先生成位LMDB格式的数据。Caffe中只需要运行下面的脚本工具即可实现。
运行mnist example第一步:制作LMDB数据发现caffe widnow的工具压根无法在windows系统环境下运行,最后我只好下载已经制作好的LMDB数据。我把下载好的train与test的LMDB放到了\caffe\data\mnist文件夹下。
第二步: 修改数据层在caffe\examples\mnist文件夹下有两个跟训练与运行相关的文件
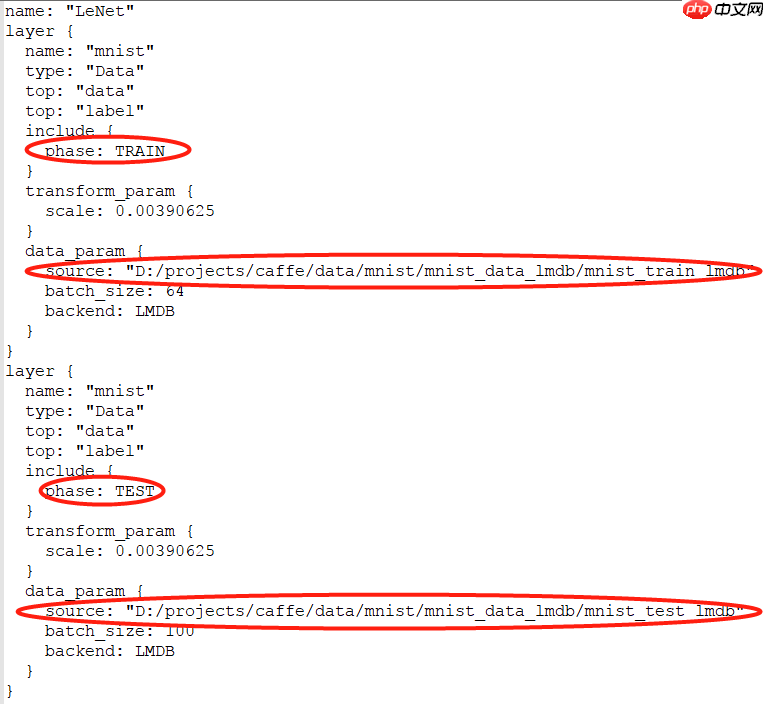
lenet_solver.prototxtlenet_train_test.prototxt这里需要打开第二个文件,打开之后修改数据输入层的数据路径部分,我修改好之后的显示如下:

当用户要求为 Java 代码添加注释、修改注释、审查注释、整理注释格式,或要求按照代码注释规范处理 Java 文件时,使用本技能。本技能用于统一生成和维护 Java 类注释模板、按 Git 对比 release 判断版本号、补充每行代码上方中文块注释、调整注释空行规则,并保持 Java 文件 UTF-8 无 BOM 编码。典型触发场景包括:补充类注释、更新 @version、检查 @author 来源、整理行尾注释、把注释放到代码上一行、检查注释是否符合规范、构建前检查 Java 注释风格。
第三步:修改训练配置文件参数
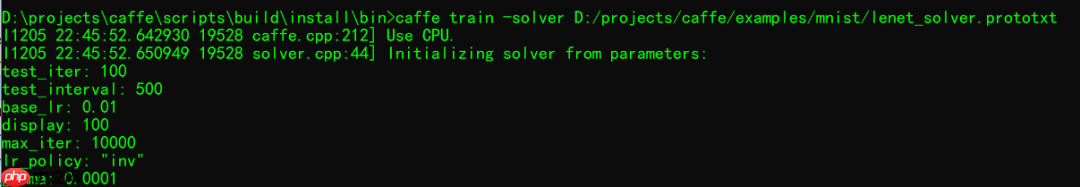
打开lenet_solver.prototxt文件,其中:
最终我的修改如下:
代码语言:javascript代码运行次数:0运行复制# The train/test net protocol buffer definitionnet: "D:/projects/caffe/examples/mnist/lenet_train_test.prototxt"# test_iter specifies how many forward passes the test should carry out.# In the case of MNIST, we have test batch size 100 and 100 test iterations,# covering the full 10,000 testing images.test_iter: 100# Carry out testing every 500 training iterations.test_interval: 500# The base learning rate, momentum and the weight decay of the network.base_lr: 0.01momentum: 0.9weight_decay: 0.0005# The learning rate policylr_policy: "inv"gamma: 0.0001power: 0.75# Display every 100 iterationsdisplay: 100# The maximum number of iterationsmax_iter: 10000# snapshot intermediate resultssnapshot: 5000snapshot_prefix: "D:/projects/caffe/examples/mnist/lenet"# solver mode: CPU or GPUsolver_mode: CPU
一切准备就绪以后,直接在命令中执行如下切换到如下目录:
代码语言:javascript代码运行次数:0运行复制D:\projects\caffe\scripts\build\install\bin
然后执行命令行
代码语言:javascript代码运行次数:0运行复制caffe train -solver D:/projects/caffe/examples/mnist/lenet_solver.prototxt
疯狂训练运行中,mnist示例caffe运行get!
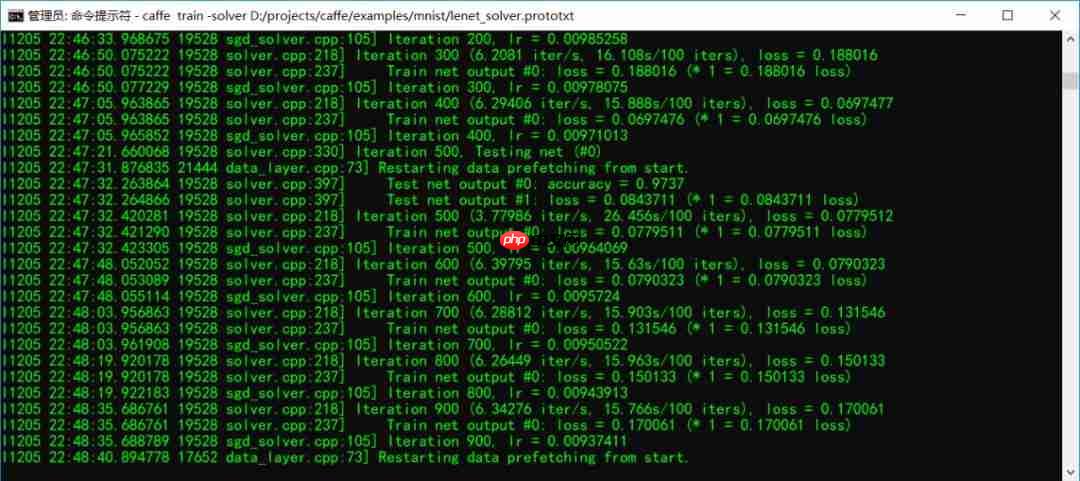
我真的一行都代码都没写,Caffe真香!
















