


作者:jay alammar
DeepSeek-R1 是人工智能(AI)进步历程中最新的一次令人瞩目的重大进展。对于机器学习(ML)研发社区来说,它是一个重要的发布版本,原因包括:
它是具有更小、经过蒸馏的版本的开放权重模型,并且它分享并反思了一种用于复现类似 OpenAI O1 的推理模型的训练方法。
在本文中,我们将了解它是如何构建的。
本文目录:
●大型语言模型(LLM)训练方式回顾
●DeepSeek-R1 训练配方
●1 - 长推理链监督式微调(SFT)数据
●2 - 一个中期高质量推理 LLM(但在非推理任务上表现较差)。
●3 - 使用大规模强化学习(RL)创建推理模型
●3.1 - 大规模推理导向强化学习(R1-Zero)
●3.2 - 使用中期推理模型创建 SFT 推理数据
●3.3 - 通用 RL 训练阶段
●模型架构
要理解此类模型的工作原理,你需要掌握的大部分基础知识都在我们的《动手实践大型语言模型》(Hands-On Large Language Models)一书中。
●大型语言模型(LLM)训练方式回顾
与大多数现有的 LLM 一样,DeepSeek-R1 每次生成一个标记,只不过它在解决数学和推理问题方面表现出色,因为它能够花费更多时间通过生成解释其推理过程的“思考标记”来处理问题。
以下图示来自我们书的第 12 章,展示了创建高质量 LLM 的一般配方,

分为三个步骤:
1)语言建模阶段,我们使用大量网络数据训练模型预测下一个单词。这一步生成基础模型。
2)监督式微调(SFT)阶段,使模型更善于遵循指令和回答问题。这一步生成指令调优模型或监督式微调(SFT)模型。
3)最后是偏好调优阶段,进一步优化其行为并使其符合人类偏好,最终生成你在各种平台和应用程序上交互的偏好调优 LLM。
●DeepSeek-R1 训练配方
DeepSeek-R1 遵循这一通用配方。第一步的详细信息来自之前关于 DeepSeek-V3 模型的论文。R1 使用之前论文中的基础模型(而不是最终的 DeepSeek-v3 模型),并且仍然要经过 SFT 和偏好调优阶段,但其执行方式的细节有所不同。
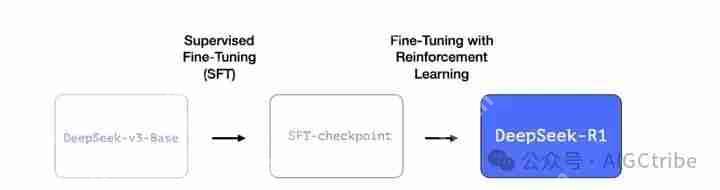
在 R1 的创建过程中,有三个特别值得关注的要点。
●1 - 长推理链监督式微调(SFT)数据
这是大量长推理链示例(60 万个)。这些数据很难获取,且在如此大规模的情况下由人工标注成本非常高昂。这就是创建这些数据的过程成为第二个值得关注的要点的原因
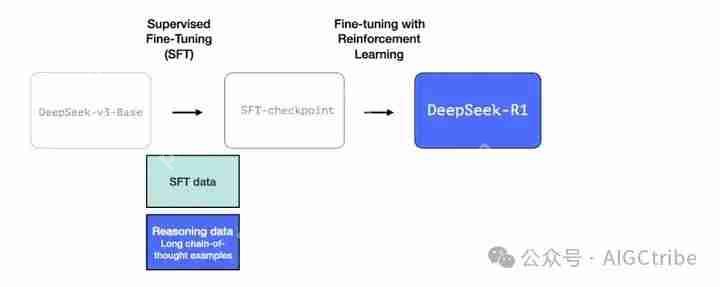
●2 - 一个中期高质量推理 LLM(但在非推理任务上表现较差)
这些数据是由 R1 的一个前身、一个未命名的兄弟模型创建的,该模型专注于推理。这个兄弟模型受到第三个模型 R1-Zero(我们稍后将讨论)的启发。它之所以重要,并不是因为它是一个出色的 LLM,而是因为创建它所需的标注数据很少,并且结合了大规模强化学习,从而生成了一个在解决推理问题方面表现出色的模型。
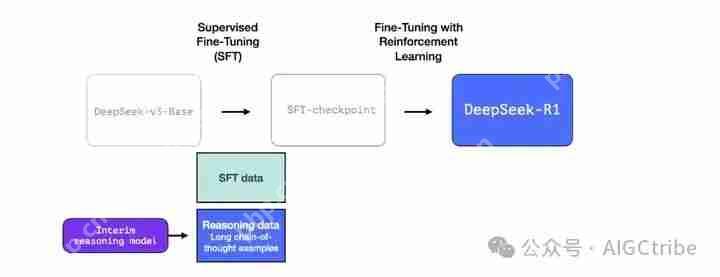
这个未命名的专门推理模型的输出随后可用于训练一个更通用的模型,使其也能执行其他非推理任务,达到用户对 LLM 的期望水平。
●3 - 使用大规模强化学习(RL)创建推理模型
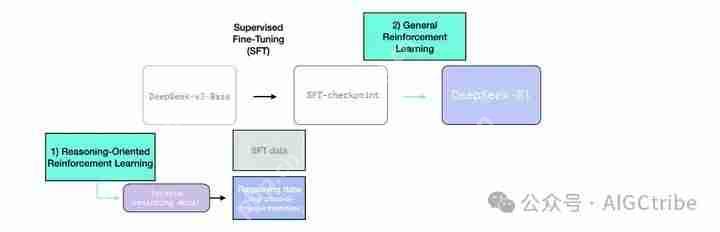
这分为两个步骤:
●3.1 大规模推理导向强化学习(R1-Zero)
在这里,RL 用于创建中期推理模型。然后该模型用于生成 SFT 推理示例。但使创建这个模型成为可能的是之前创建一个名为 DeepSeek-R1-Zero 的早期模型的实验。
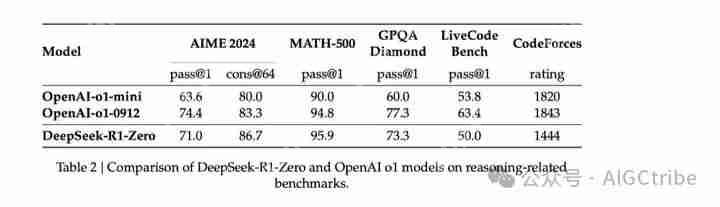
R1-Zero 的特殊之处在于它能够在没有标注的 SFT 训练集的情况下在推理任务上表现出色。它的训练直接从预训练基础模型通过 RL 训练过程(没有 SFT 步骤)进行。它在这方面做得如此出色,以至于与 o1 具有竞争力。
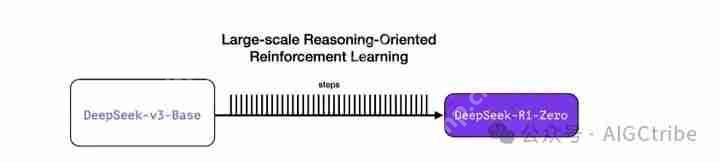
这很重要,因为数据一直是 ML 模型能力的“燃料”。这个模型如何能摆脱这一普遍要求?这指向了两个方面:

1 - 现代基础模型已经跨越了某个质量门槛(这个基础模型是使用 14.8 万亿个高质量标记训练的)。
2 - 与一般的聊天或写作请求不同,推理问题可以自动验证或标注。让我们通过一个示例来说明这一点。
示例:推理问题的自动验证
这可以是 RL 训练步骤中的一个提示或者问题:
编写 Python 代码,接受一个数字列表,以排序顺序返回它们,同时在开头添加 42。
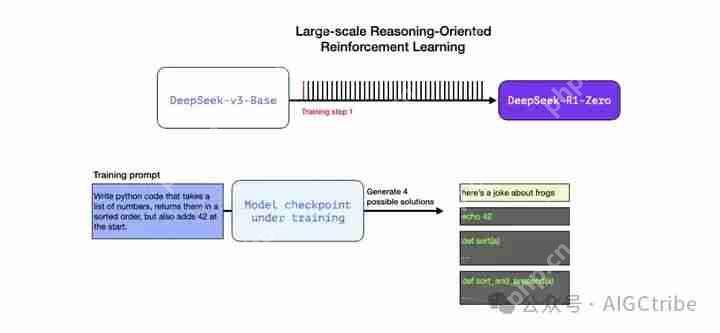
像这样的问题有很多自动验证的方法。假设我们将这个问题呈现给正在训练的模型,它生成了一个补全内容:
一个软件代码检查工具可以检查补全内容是否是正确的 Python 代码。
我们可以运行 Python 代码,看看它是否能正常运行。
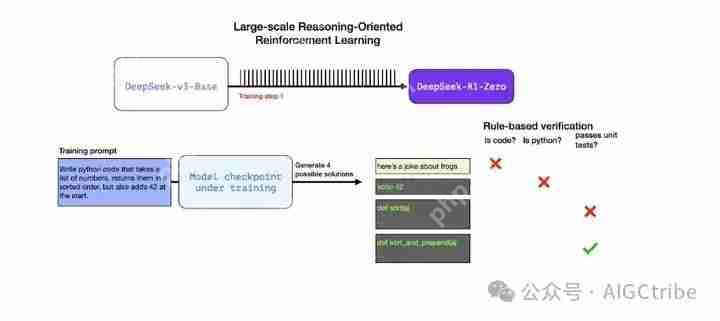
其他现代编码 LLM 可以创建单元测试来验证所需行为(即使它们本身不是推理专家)。
我们还可以更进一步,测量执行时间,并使训练过程更倾向于选择性能更优的解决方案,即使它们是能解决问题的正确 Python 程序。
我们可以在训练步骤中向模型呈现像这样的问题,并生成多个可能的解决方案。
我们可以自动检查(无需人工干预)并发现第一个补全内容甚至不是代码。第二个是代码,但不是 Python 代码。第三个是一个可能的解决方案,但未通过单元测试,而第四个是一个正确的解决方案。
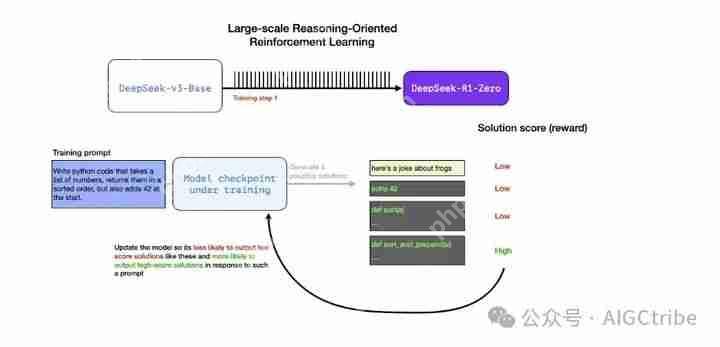
这些都可以直接用作改进模型的信号。当然,这是在许多示例(以小批量)和连续训练步骤中完成的。
这些奖励信号和模型更新是模型在 RL 训练过程中不断改进任务的方式,如论文中的图 2 所示。
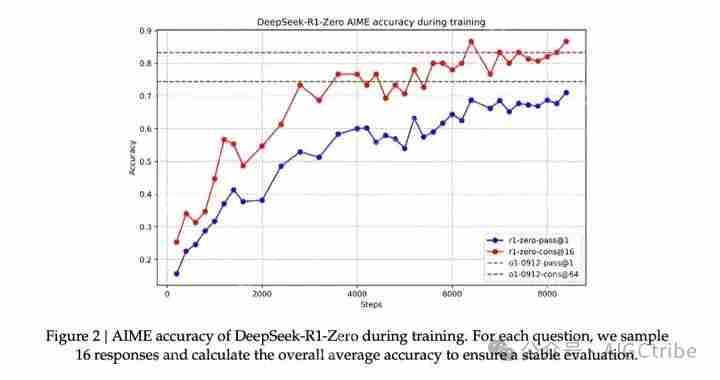
随着这种能力的提升,生成响应的长度也会增加,模型会生成更多的“思考标记”来处理问题。
这一过程很有用,但 R1-Zero 模型尽管在这些推理问题上得分很高,但面临其他问题,使其不如预期的那样可用。
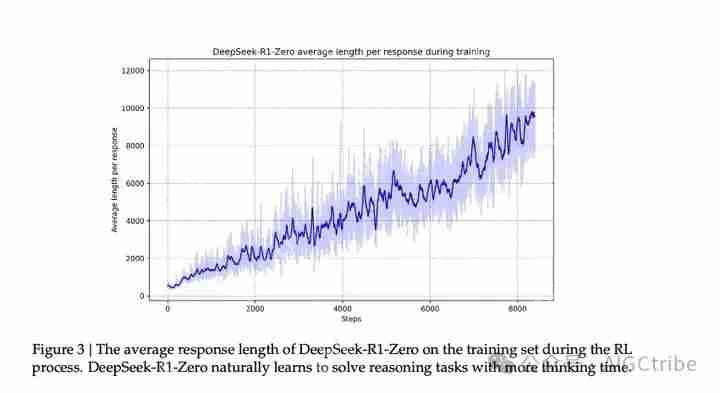
尽管 DeepSeek-R1-Zero 在推理能力方面表现出色,并且自主开发出意想不到的强大推理行为,但它面临几个问题。例如,DeepSeek-R1-Zero 在诸如可读性差和语言混用等挑战方面表现不佳。
R1 是为了成为一个更可用的模型。因此,正如我们在本节前面提到的,RL 过程在两个地方被使用:
1 - 创建一个中期推理模型以生成 SFT 数据点
2 - 训练 R1 模型以改进推理和非推理问题(使用其他类型的验证器)
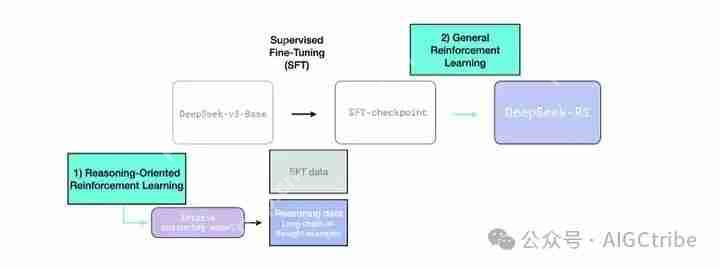
●3.2 使用中期推理模型创建 SFT 推理数据
为了使中期推理模型更有用,它在少量推理问题示例(其中一些是从 R1-Zero 生成和筛选的)上进行了监督式微调(SFT)训练。论文中将此称为“冷启动数据”。
冷启动:与 DeepSeek-R1-Zero 不同,为了防止从基础模型开始的 RL 训练的早期不稳定冷启动阶段,对于 DeepSeek-R1,我们构建并收集了一小部分长推理链数据,以微调模型作为初始 RL 行为者。为了收集此类数据,我们探索了多种方法:使用带有长推理链示例的少样本提示,直接提示模型生成带有反思和验证的详细答案,收集格式可读的 DeepSeek-R1- Zero 输出,并通过人工标注者进行后处理来完善结果。
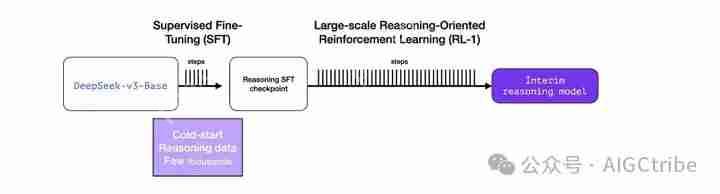
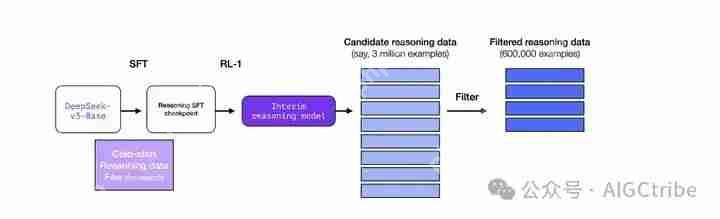
但是,如果我们有这些数据,为什么还要依赖 RL 过程呢?这是因为数据的规模。这个数据集可能有 5000 个示例(这是可以获取的),但要训练 R1,需要 60 万个示例。这个中期模型弥合了这一差距,允许合成生成这种极其有价值的数据。
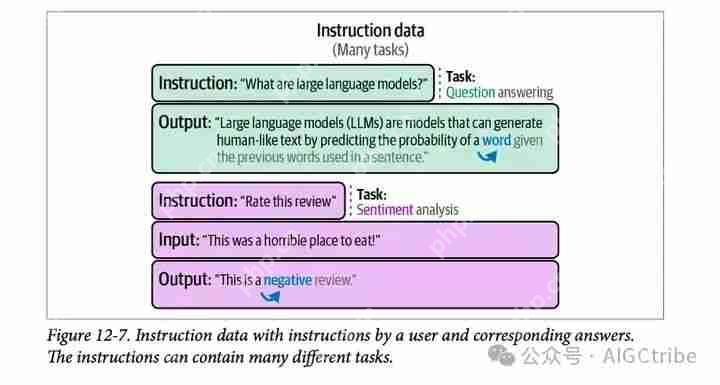
如果你对监督式微调(SFT)这一概念还不熟悉,那就是向模型呈现以提示和正确补全形式的训练示例的过程。第 12 章的这幅图展示了几个 SFT 训练示例:
●3.3 通用 RL 训练阶段
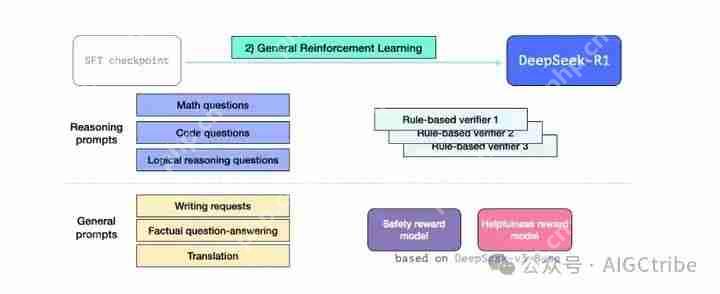
这使 R1 能够在推理以及其他非推理任务上表现出色。该过程与我们之前看到的 RL 过程类似。但由于它扩展到非推理应用,因此对于属于这些应用的提示,它使用了一个有用性和安全性奖励模型(与 Llama 模型类似)。
●模型架构
与 GPT2 和 GPT 3 问世之初的模型一样,DeepSeek-R1 是一堆 Transformer 解码器块。它由 61 个这样的块组成。
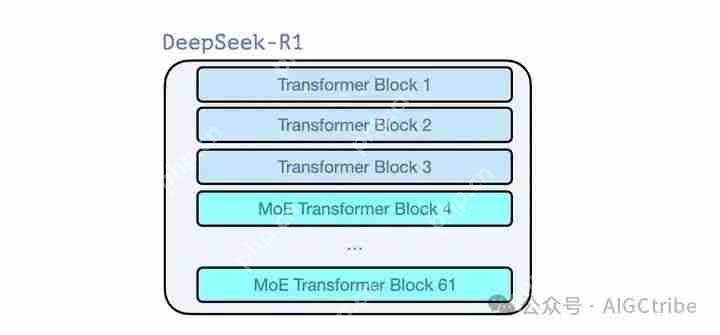
前三个是密集的,但其余的是专家混合(MoE)层(详见我的合著者 Maarten 的精彩入门指南:《专家混合(MoE)图解指南》)。
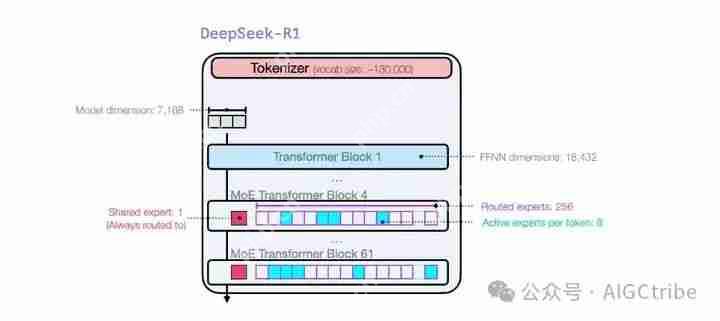
就模型维度大小和其他超参数而言,它们如下所示:
关于模型架构的更多详细信息在他们之前的两篇论文中有所介绍:
《DeepSeek-V3 技术报告》
《DeepSeekMoE:朝着专家混合语言模型的终极专业化方向发展》
至此,你应该已经掌握了围绕 DeepSeek-R1 模型的主要训练方法

















